目錄
30 天工程專案 · Atari 打磚塊
從零訓練打磚塊 AI 的 30 天,以及一支不用訓練就贏過它的程式
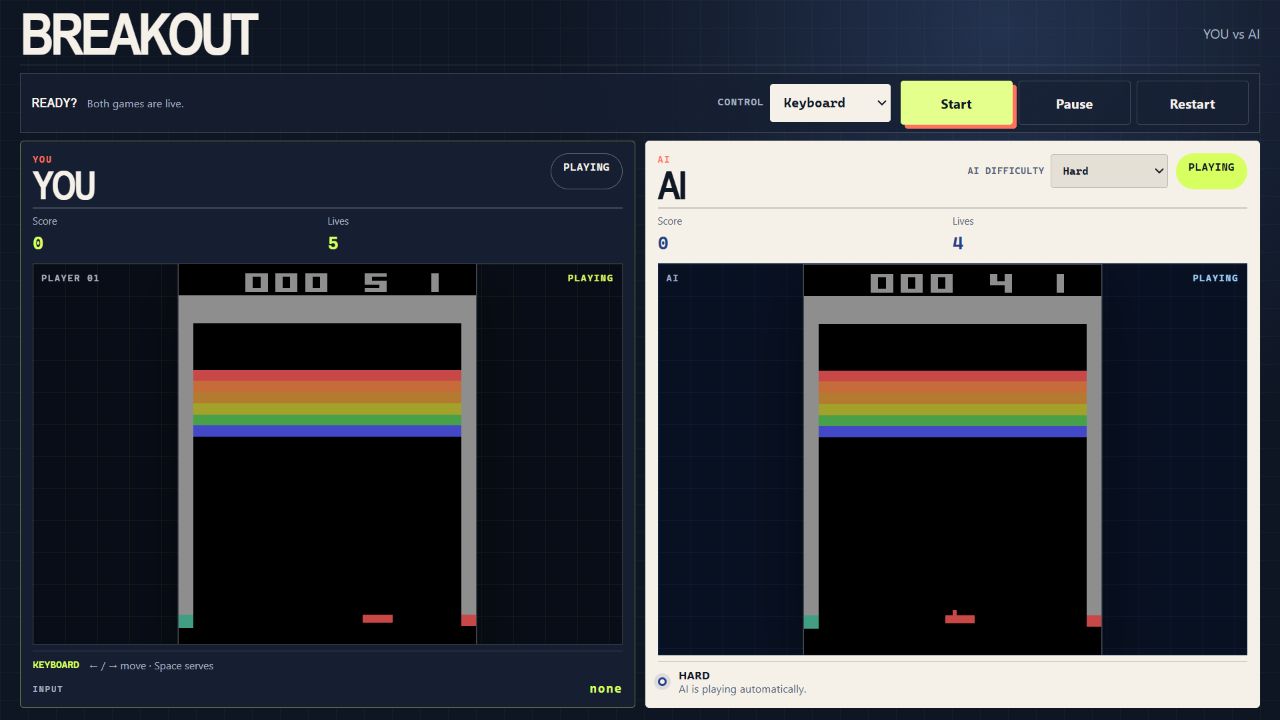
目標是讓神經網路自己看畫面、自己學會打磚塊。30 天後它真的能在瀏覽器裡和人並肩開局;但把同一套規則交給一支只算球路的追蹤程式,它打得比練了兩百萬格畫面的神經網路好得多。
- 同一套規則下的平均分:追蹤程式 vs 神經網路
- 721.8 對 6.93
- 打光兩面牆的局數,每一局都由程式判定
- 4/15
- 搬進瀏覽器後,測試畫面上動作一致
- 60/60
30 天路線圖
三十天分成六段,外加「30 天之後」那一段。每一段完成一件事,也留下一個可以檢查的結果;完整的方法、圖表與逐局紀錄都在完整案例研究。
- Day 1–4 · 把遊戲接上程式:遊戲、畫面與計分規則固定下來,之後的比較才有同一個起點。
- Day 5–12 · 從零寫出 DQN:一個看得懂、也訓練得起來的網路。
- Day 13–15 · 第一次評估就抓到 bug:平均分贏了隨機亂按,卻有三分之二的局卡在等待發球;發球改由環境負責。
- Day 16–21 · 加速、比較、長訓練:選出 Dueling Double DQN,也發現「挑模型」本身會把分數挑高。
- Day 22–29 · 搬進瀏覽器:固定測試畫面上動作全部一致,同一個開局在三個環境打出同樣分數。
- Day 30 · 第一次總結:把三十天整理成核心系列文章。
- 30 天之後 · 追蹤程式與破關驗證:不用訓練的程式平均分遠高於神經網路,並由程式判定打光兩面牆。
後來的轉折:不用訓練,反而打得更好
三十天結束時,神經網路離打光兩面牆還很遠。但打磚塊的畫面很單純:球和球拍顏色分明,球在兩次反彈之間幾乎走直線。於是我寫了一支追蹤程式:看同樣的畫面,找出球與球拍、從前後幾格估出球速、把撞牆反彈算進去、預測落點,每一格只算幾行算式,每次決策約 2.03 毫秒。
公平比較要用同一套規則。神經網路一路是每 4 格畫面決定一次,追蹤程式需要每格都決定,所以我在「每格都決定」的規則下另外訓練了一個神經網路,兩邊各玩同樣的 15 局:追蹤程式平均 721.8 分,神經網路 6.93 分。15 局裡有 4 局打光兩面牆(滿分 864 分),而且判定不靠肉眼:判定器讀遊戲記憶體裡的計分板,先用自己的三種真實軌跡驗證,再用 6 種故意改壞的方式確認測試每一種都抓得到。這六種改壞方式與逐局紀錄都在完整案例研究裡。
為什麼神經網路只有 6.93 分?
一個假設是:變難的是規則,不只是模型。原本的模型每 4 格畫面才決定一次;改成每格都決定之後,同一段遊戲時間要連續做 4 倍的決策,每一次決策都得往後想得更遠——有效時間跨度變成 4 倍,學習目標裡的獎勵也退到更遠的地方。另一個限制是訓練量:這套規則下它只完整訓練過一次,約兩百萬格畫面,而且沒有留下第二次訓練可以對照。
所以下一步要做的,不是再挑一個最好看的分數,而是把這兩件事拆開:
- 對照組:把同一組網路放回「每 4 格決定一次」的規則,用同樣的 15 局測。這樣才分得清差別來自規則變難,還是模型不夠好。
- 實驗組:在「每格都決定」下做三次獨立訓練,各練五百萬格畫面,不讓單一次訓練定生死。
- 兩組都用同一批 15 局、同一個判定器,並沿用專案既有的採用門檻,同時看平均分與打光局數,而不是只看最高分。
在跑完之前,這裡只說一件事:在這個規模、這套規則、這次訓練下,算的比學的好;還不能推論神經網路學不會。