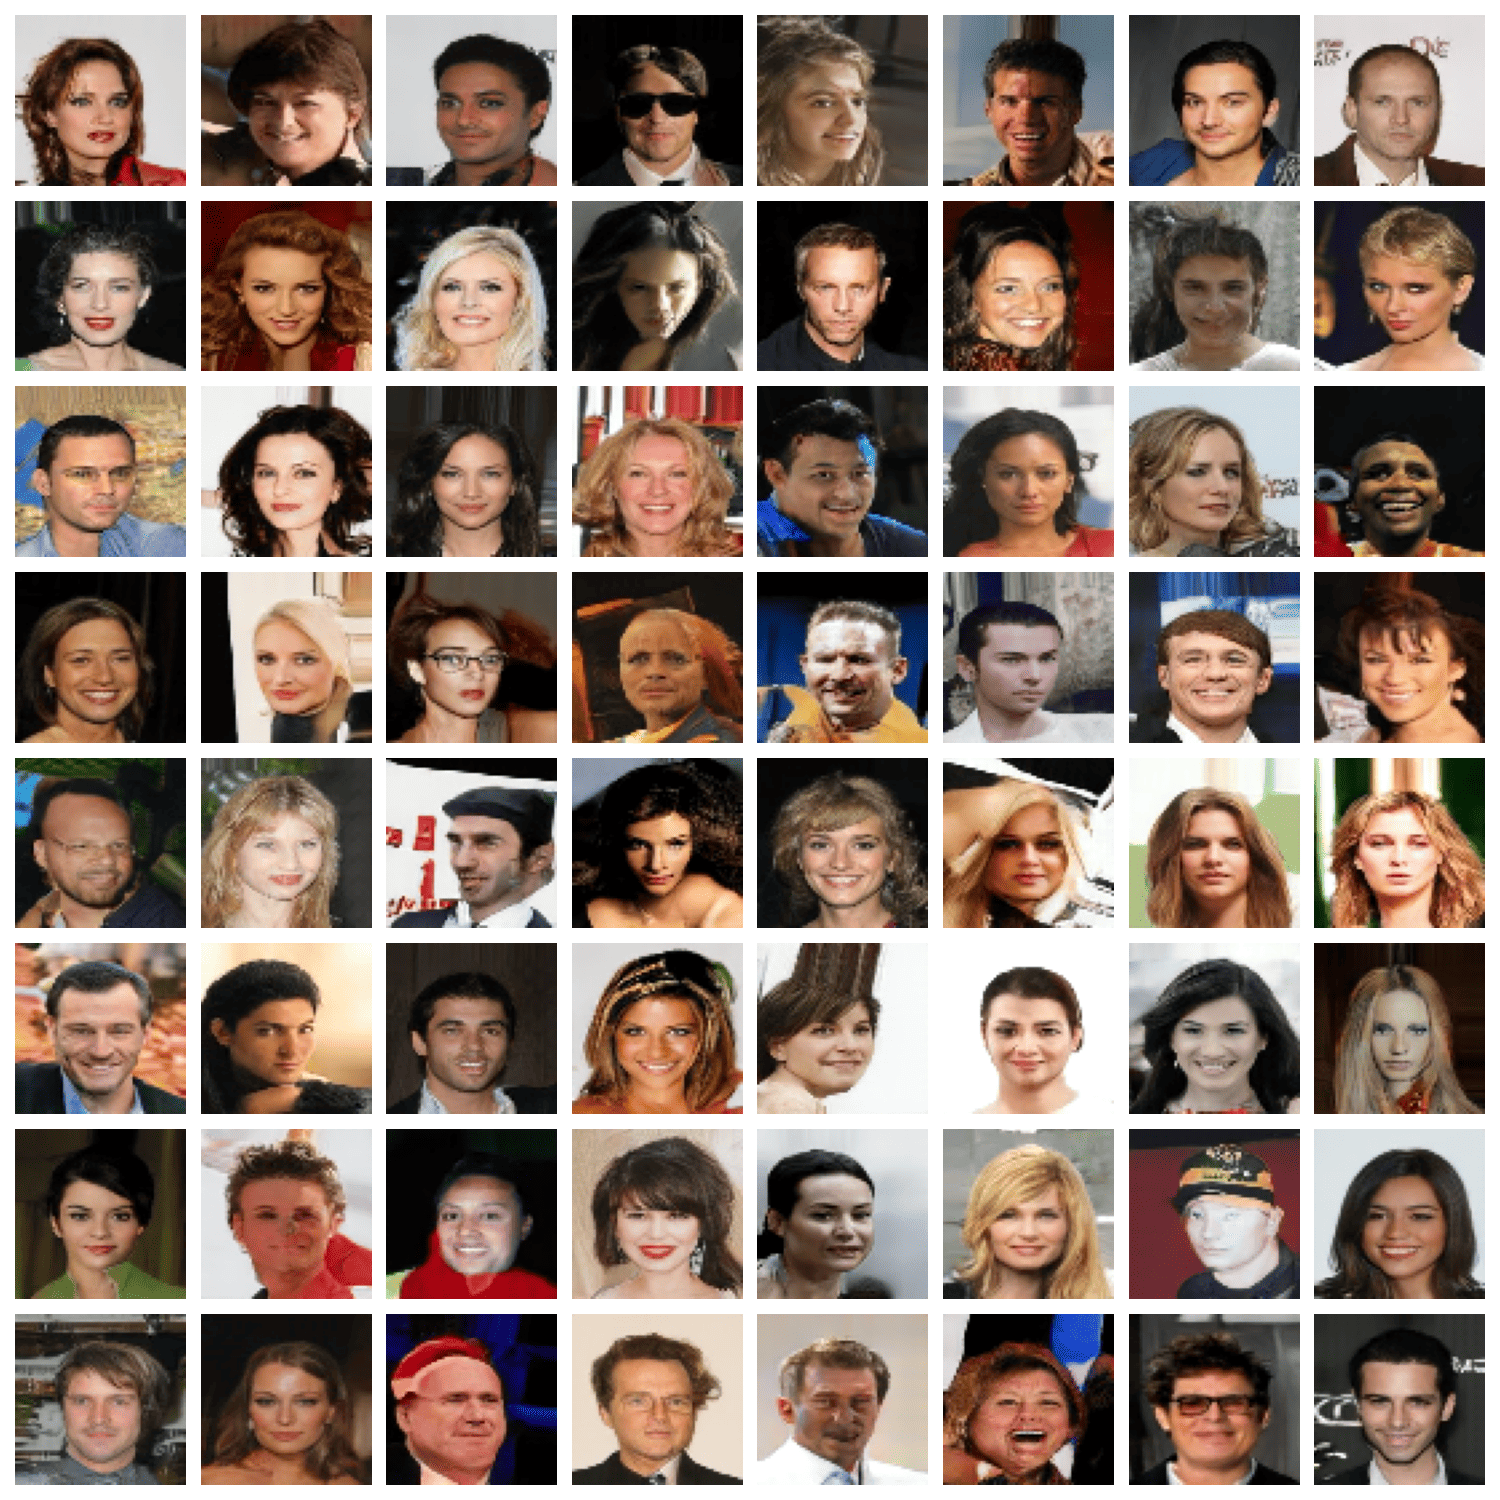
這是我在國立東華大學「深度學習基石與實務」課程完成的人臉生成與分類實驗。前半段訓練模型產生 64×64 的人臉圖片,後半段把生成圖片與真實照片混合,訓練另一個模型辨別真假。
生成人臉,要兼顧細節與多樣性
生成模型的訓練包含兩個互相競爭的部分:一個負責產生圖片,另一個判斷圖片是真是假。生成器根據判斷結果調整輸出,逐漸學習人臉的外觀。
實驗中,有些模型產生的細節變清楚,卻開始反覆生成少數幾種臉型;另一些方法改善了多樣性,但訓練成本增加。我比較不同架構後採用 LadaGAN,並保留各階段的生成圖片,觀察清晰度與臉型變化,而不只挑選最好看的單張結果。
用不同訓練階段的圖片建立資料集
我從 30 個選定的模型存檔中,各生成 5,000 張圖片,合計約 150,000 張。不同訓練階段的圖片品質與風格不同,把它們和真實 CelebA 人臉照片混合,能讓分類模型接觸多種生成結果。
真假分類最後使用 EfficientNetV2-B1,沿用已學到的影像特徵,再針對這份資料微調。這個階段也需要統一圖片尺寸與前處理,避免模型只靠資料處理留下的差異來區分真假。
真假分類的評估結果
原始報告記錄,在一組 30,000 張評估圖片中,模型判對 29,972 張,約 99.907%。這個結果描述的是該組資料上的分類表現。