LadaGAN 做得太逼真之後:一場生成器與判別器的拉鋸
從 LadaGAN 人臉生成、150K 合成資料到 EfficientNetV2-B1 真假分類,整理模型比較、生成樣本與評估結果。
文章目錄
這是我在國立東華大學資訊工程學系「深度學習基石與實務」課程的第二個作業。我在 CelebA 上訓練 LadaGAN,從不同訓練階段建立合成人臉資料集,再訓練模型辨別真實與生成影像。
我一開始以為生成器越逼真,成果就越好。跑過幾輪模型後,卻遇到清晰度提高、臉型變得單一,以及分類模型接近隨機猜測的情況。下面用生成樣本、訓練曲線與評估結果,說明這些問題如何影響模型選擇。
這個實驗真正要回答什麼?
這份作業的目標不是只交出一張「看起來像人臉」的圖片,而是一條可以被檢查、被重跑的影像生成與分類流程:
- 在 CelebA 上訓練 LadaGAN,產生有多樣性的 64×64 人臉。
- 依報告記錄的不同 epoch checkpoint,從每個 checkpoint 生成固定數量的圖片,建立足夠大的 synthetic dataset。
- 把真實圖片和生成圖片混合,訓練多個影像分類模型,找出比較能辨識兩種影像分布的判別器。
- 使用最後的 EfficientNetV2-B1 對測試資料做真偽判斷,輸出 test.csv。
所以我想回答的問題不是「能不能生成一張好看的臉」,而是:
當生成器已經做得很逼真時,判別器到底還能不能學到穩定、可泛化的差異?
為什麼要把生成與判別放在同一條 pipeline?
HackMD 報告把整個工作拆成三個階段。第一階段訓練 LadaGAN;第二階段從生成 checkpoint 建立判別器資料;第三階段用教師提供的 1,000 張測試圖片產生最後的分類結果。

箭頭表示資料與模型的先後關係:生成器先留下多個 checkpoint,再從它們建立 synthetic faces;判別器的資料集才把 real 與 fake 合併,最後輸出評估結果或教師測試集的 test.csv。圖中最重要的界線是 30,000 張評估資料與 1,000 張盲測圖片不是同一組資料。
三個階段的實際數字
第一階段以 64×64、像素值正規化到 [-1, 1] 的 CelebA 人臉訓練 LadaGAN。訓練曲線記錄到第 36 個 epoch;生成資料的腳本則以第 1 到第 30 個 checkpoint、每個 checkpoint 5,000 張圖片為主要設定:
30 checkpoints × 5,000 images = 150,000 synthetic faces
第二階段再把 150,000 張生成圖片和 202,600 張真實圖片按報告中的比例抽樣,組成 300,000 張判別器資料。報告中提到的分布是 127,650 張 fake、172,350 張 real;這個比例比單純各半抽樣更接近原始資料配置。
第三階段使用教師提供的 1,000 張測試圖片,由模型產生分類結果並輸出 test.csv。
生成資料腳本使用 30 個模型存檔,每個產生 5,000 張圖片,合計 150,000 張。
LadaGAN 的架構與訓練方式
LadaGAN 的生成器不是單純把卷積層一路堆高,而是把 Transformer-style attention、residual connection 和逐步上採樣放在同一個生成流程裡。報告中記錄的主要設定是:
| 元件 | 設定 |
|---|---|
| latent noise | 128 維 |
| generator output | 64×64 RGB |
| generator model dimensions | [1024, 256, 64] |
| attention heads | [4, 4, 4] |
| MLP dimensions | [512, 512, 512] |
| discriminator input | 64×64 影像 patch embedding |
| discriminator patch size | 4 |
我把訓練流程理解成兩個互相拉扯的目標:
- 生成器要讓 fake image 通過判別器,同時維持 feature matching,避免只追求某一種容易成功的臉型。
- 判別器要同時看 real 和 fake,學會把生成影像的細微分布差異轉成可用的 binary signal。
報告中的生成器 loss 可以概括成:
generator_loss = adversarial_loss + 10 × feature_matching_loss
判別器則使用 real/fake 的 sigmoid cross entropy。這個 10 不是裝飾性超參數:它直接改變了生成器在「騙過判別器」和「維持特徵分布」之間的重心。
先看失敗:模型演進的四個階段
我沒有把最終的 LadaGAN 當成一開始就知道的答案。生成器只反覆產生少數幾種樣式時,這種現象叫做 mode collapse(模式崩潰);實驗中比較過的模型,剛好把 GAN 常見的問題逐一暴露出來:
| 階段 | 得到的改善 | 暴露出的問題 |
|---|---|---|
| DCGAN | 建立最基本的生成流程 | 圖片較模糊、局部紋理不足,容易出現 mode collapse |
| DCGAN + Self-Attention | 更早捕捉全局關係,細節變清楚 | 模式集中更嚴重,生成結果可能突然崩潰 |
| WGAN-GP | 多樣性與訓練穩定度改善 | gradient penalty 加上多次 critic update,速度約慢 3–4 倍,細節反而變糊 |
| LadaGAN | 以 Linear Additive-Attention 取得清晰度、多樣性和效率的折衷 | 圖片太像真的之後,判別器更難找到穩定的泛化線索 |
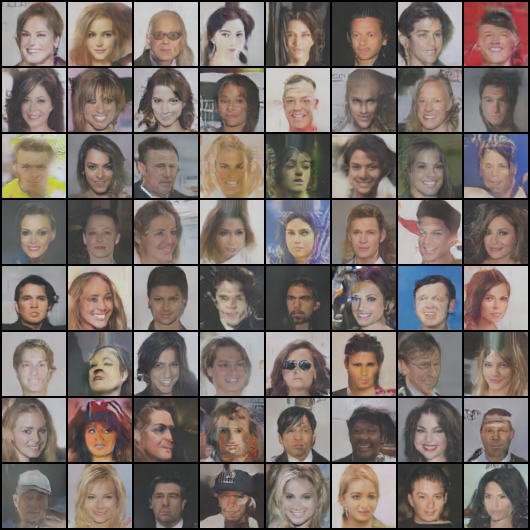
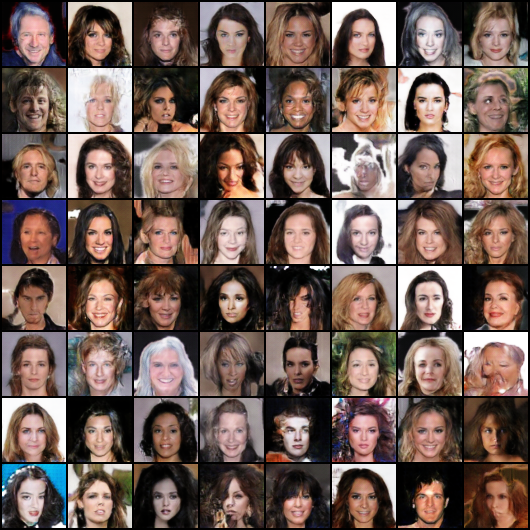
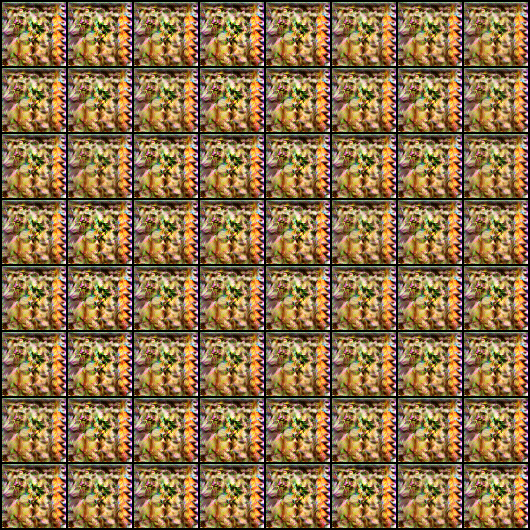
下面是各模型在不同訓練階段留下的生成圖片,可以觀察模糊程度、臉型多樣性與樣式集中情況。
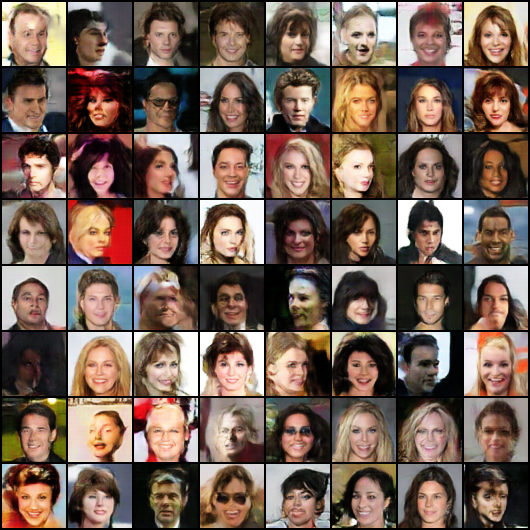
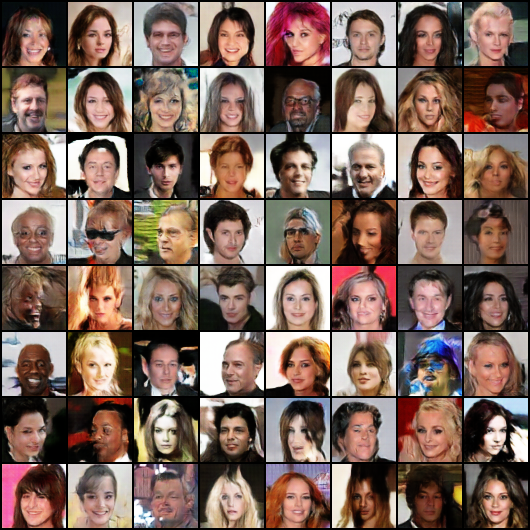
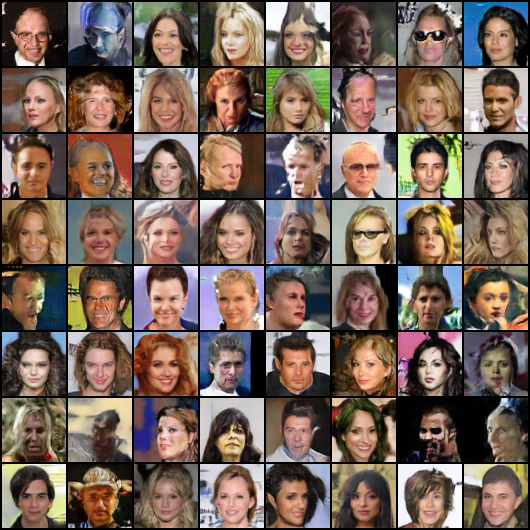
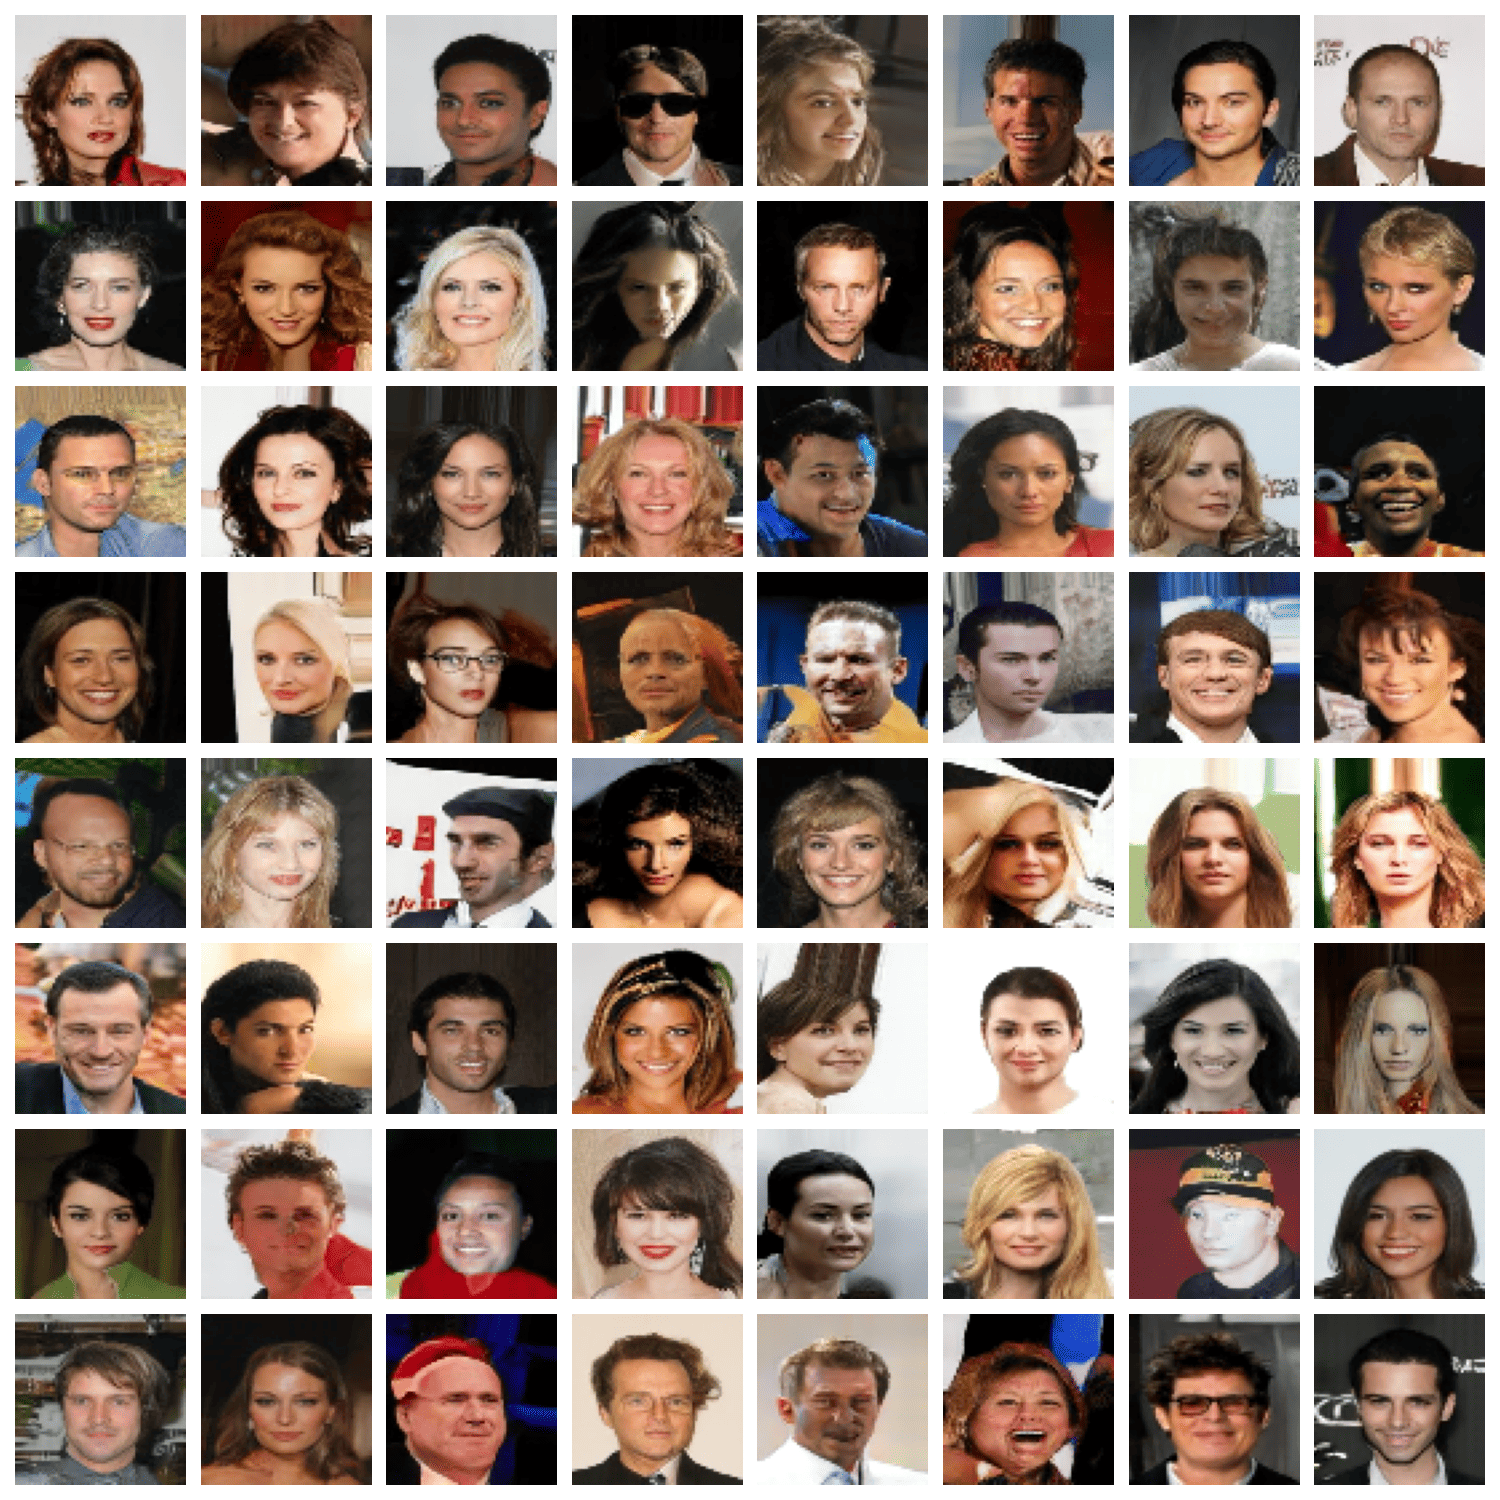
為什麼 attention 不是萬靈丹
Self-Attention 讓模型可以在更大的範圍內交換資訊,這確實有助於眼睛、鼻子、臉型等區域形成比較一致的關係。但它也會把「一組已經成功的特徵組合」快速傳播到更多位置。當梯度主要鼓勵某幾種臉型時,attention 可能讓這些成功模式被反覆複製,清晰度提高的同時,多樣性反而下降。
WGAN-GP 解決的是另一個問題:讓負責評分的一方(critic)的學習訊號更平滑,降低 mode collapse 的風險。但每次 generator update 前需要多次 critic update,再加上 gradient penalty,訓練成本明顯增加。這就是為什麼我最後沒有只看「哪一個模型的理論保證比較漂亮」,而是回到這份作業要交付的完整 pipeline,選擇成本可接受、輸出也足夠清楚的 LadaGAN。
36 個 epoch 的 loss:生成器變強,也讓判別器更難工作
下面是 HackMD 報告中的原始 loss 與 score 圖。左側是 generator/discriminator loss,右側是 real/fake score;圖上的 fake score 是判別器記錄的 raw score,不是 sigmoid 後的機率。
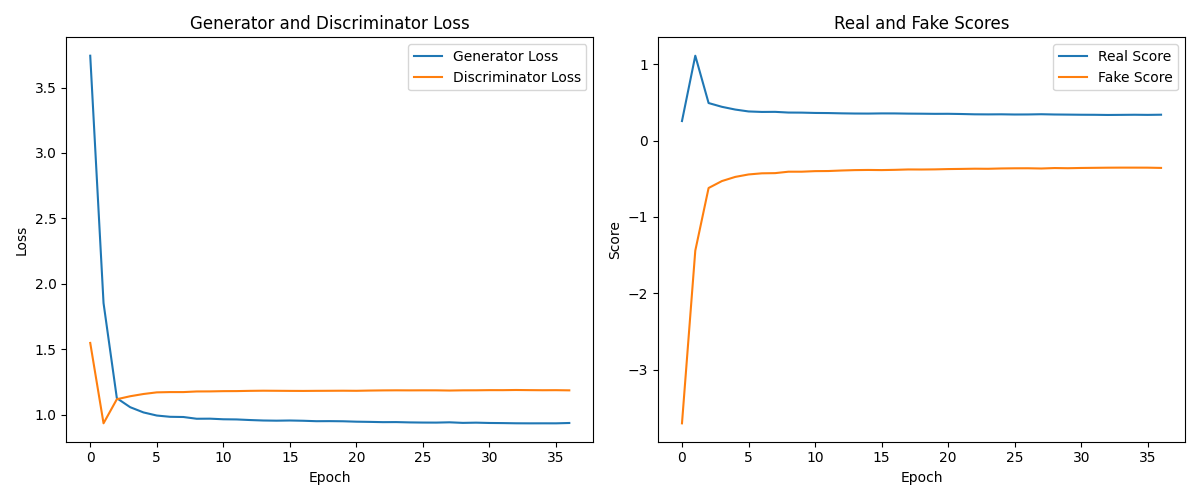
報告把曲線分成四個階段,這樣比只看最後一個數字更能看出訓練發生了什麼:
| 訓練階段 | Generator loss | Discriminator loss | Real score | Fake score |
|---|---|---|---|---|
| epoch 0 → 5 | 3.74 → 0.98 | 1.55 → 1.17 | 0.26 → 0.38 | -3.71 → -0.44 |
| epoch 6 → 15 | 0.98 → 0.95 | 1.17 → 1.18 | 0.38 → 0.35 | -0.44 → -0.38 |
| epoch 16 → 25 | 0.95 → 0.94 | 1.18 → 1.19 | 0.35 → 0.34 | -0.38 → -0.36 |
| epoch 26 → 36 | 0.94 → 0.94 | 1.19 → 1.19 | 0.34 → 0.34 | -0.36 → -0.36 |
最後一個記錄點是:
- generator loss:0.936
- discriminator loss:1.185
- real score:0.339
- fake score:-0.358
前五個 epoch 是主要的快速學習期,生成器 loss 大幅下降,real/fake score 也快速靠近相對穩定的區間;第 6 個 epoch 之後,兩個 loss 幾乎進入平台期。各階段的生成圖片則呈現了人臉細節與多樣性的變化。
把每個 checkpoint 都留下來
這一組圖是報告中不同 epoch 的實際生成結果。每張大圖是 contact sheet,裡面包含同一個 checkpoint 產生的多張人臉;我保留 epoch 1、2、5、10、15、20、25、30、36,讓讀者可以沿著同一條時間軸看品質與多樣性如何變化。
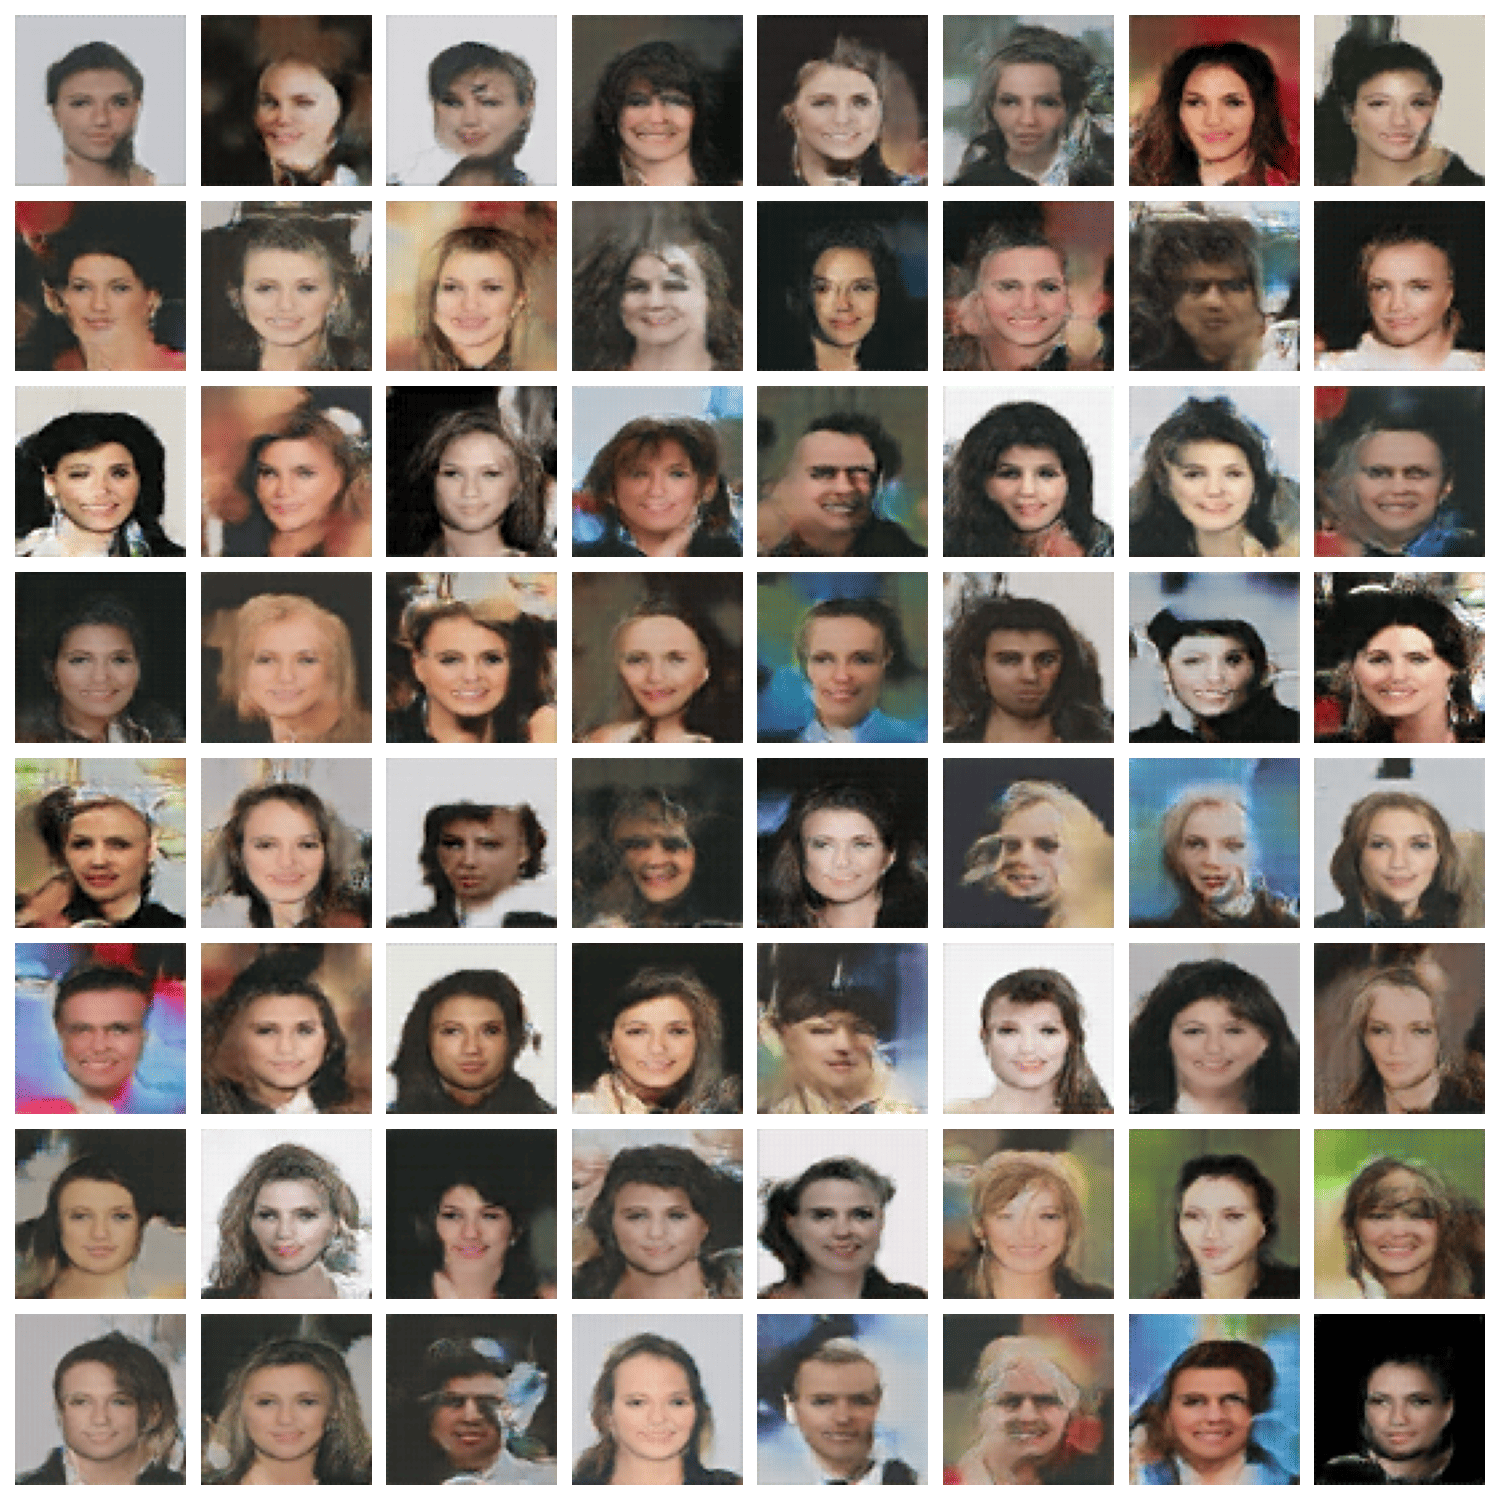
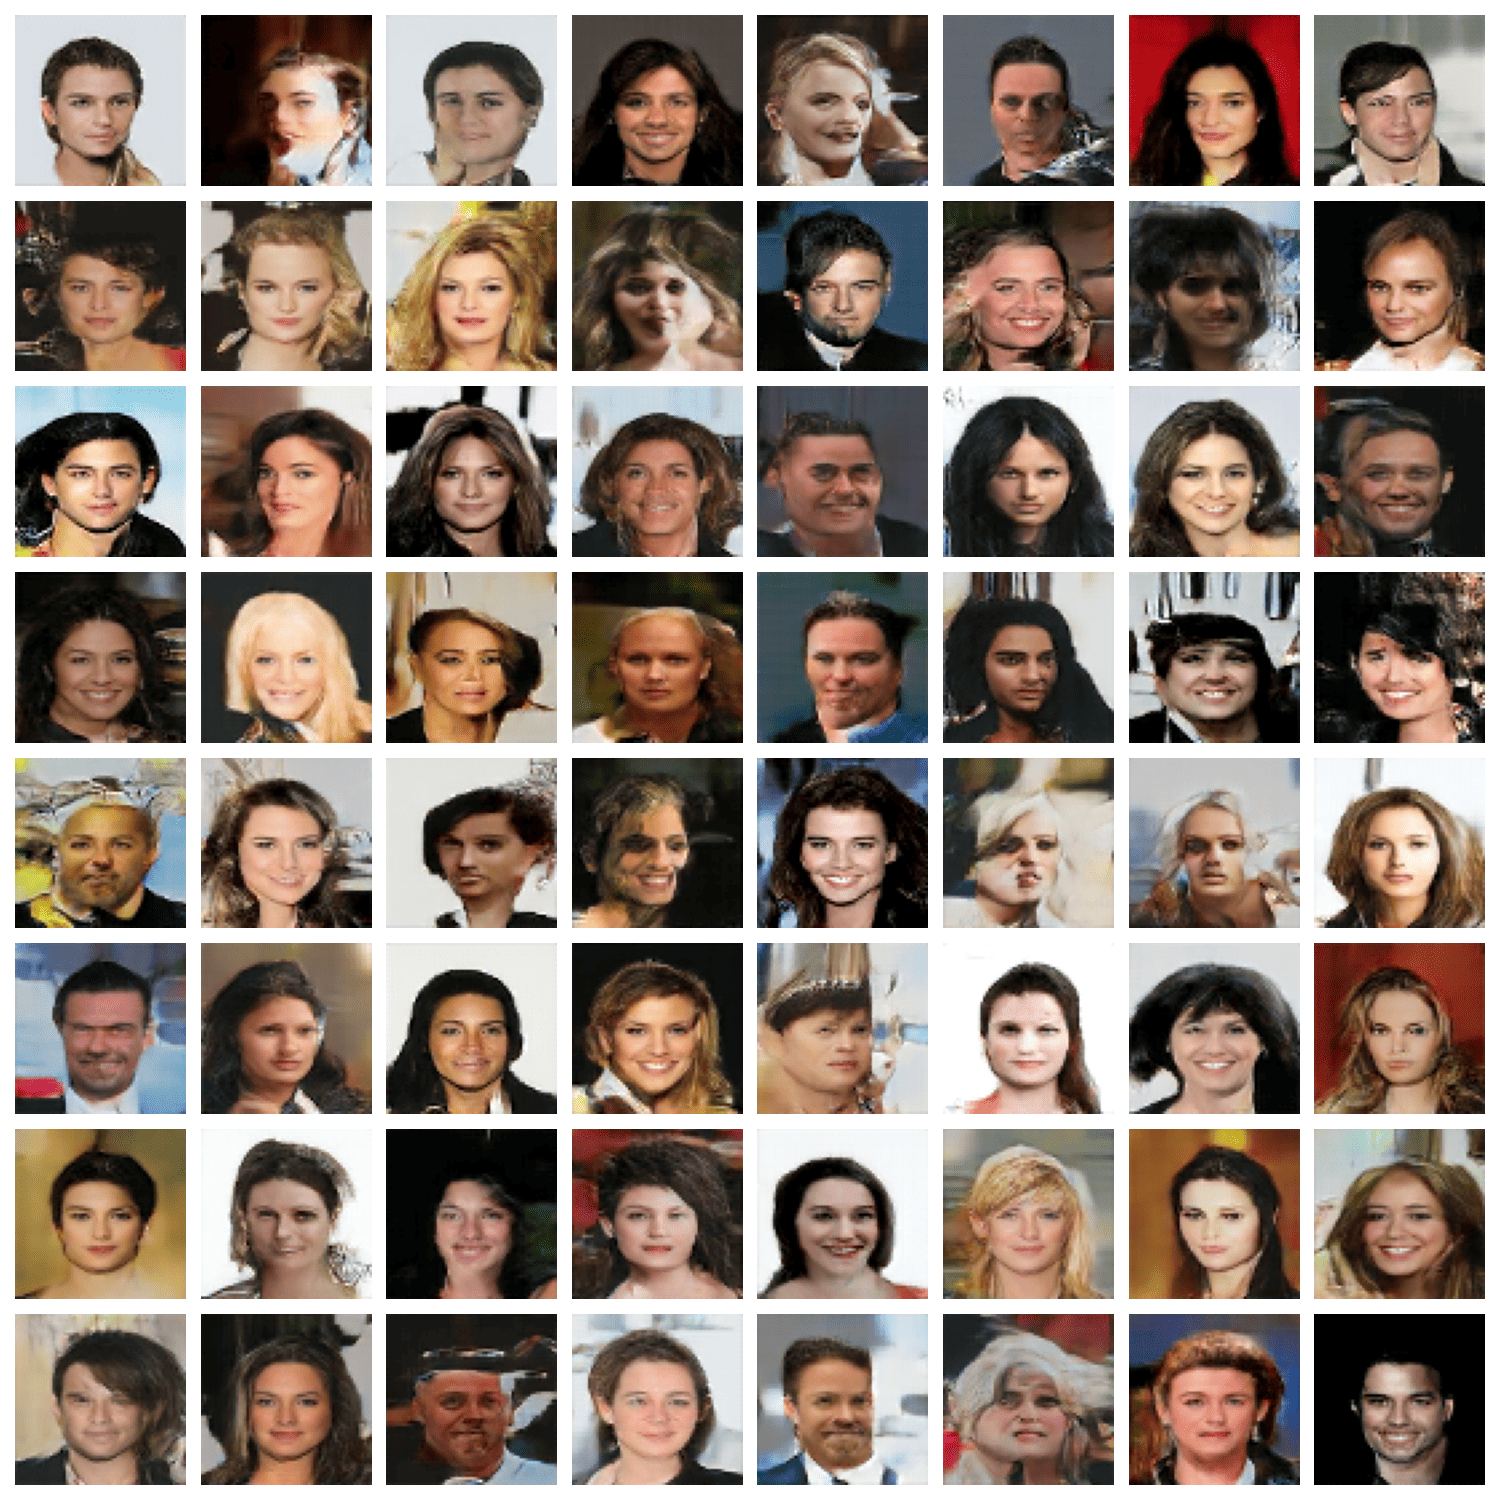
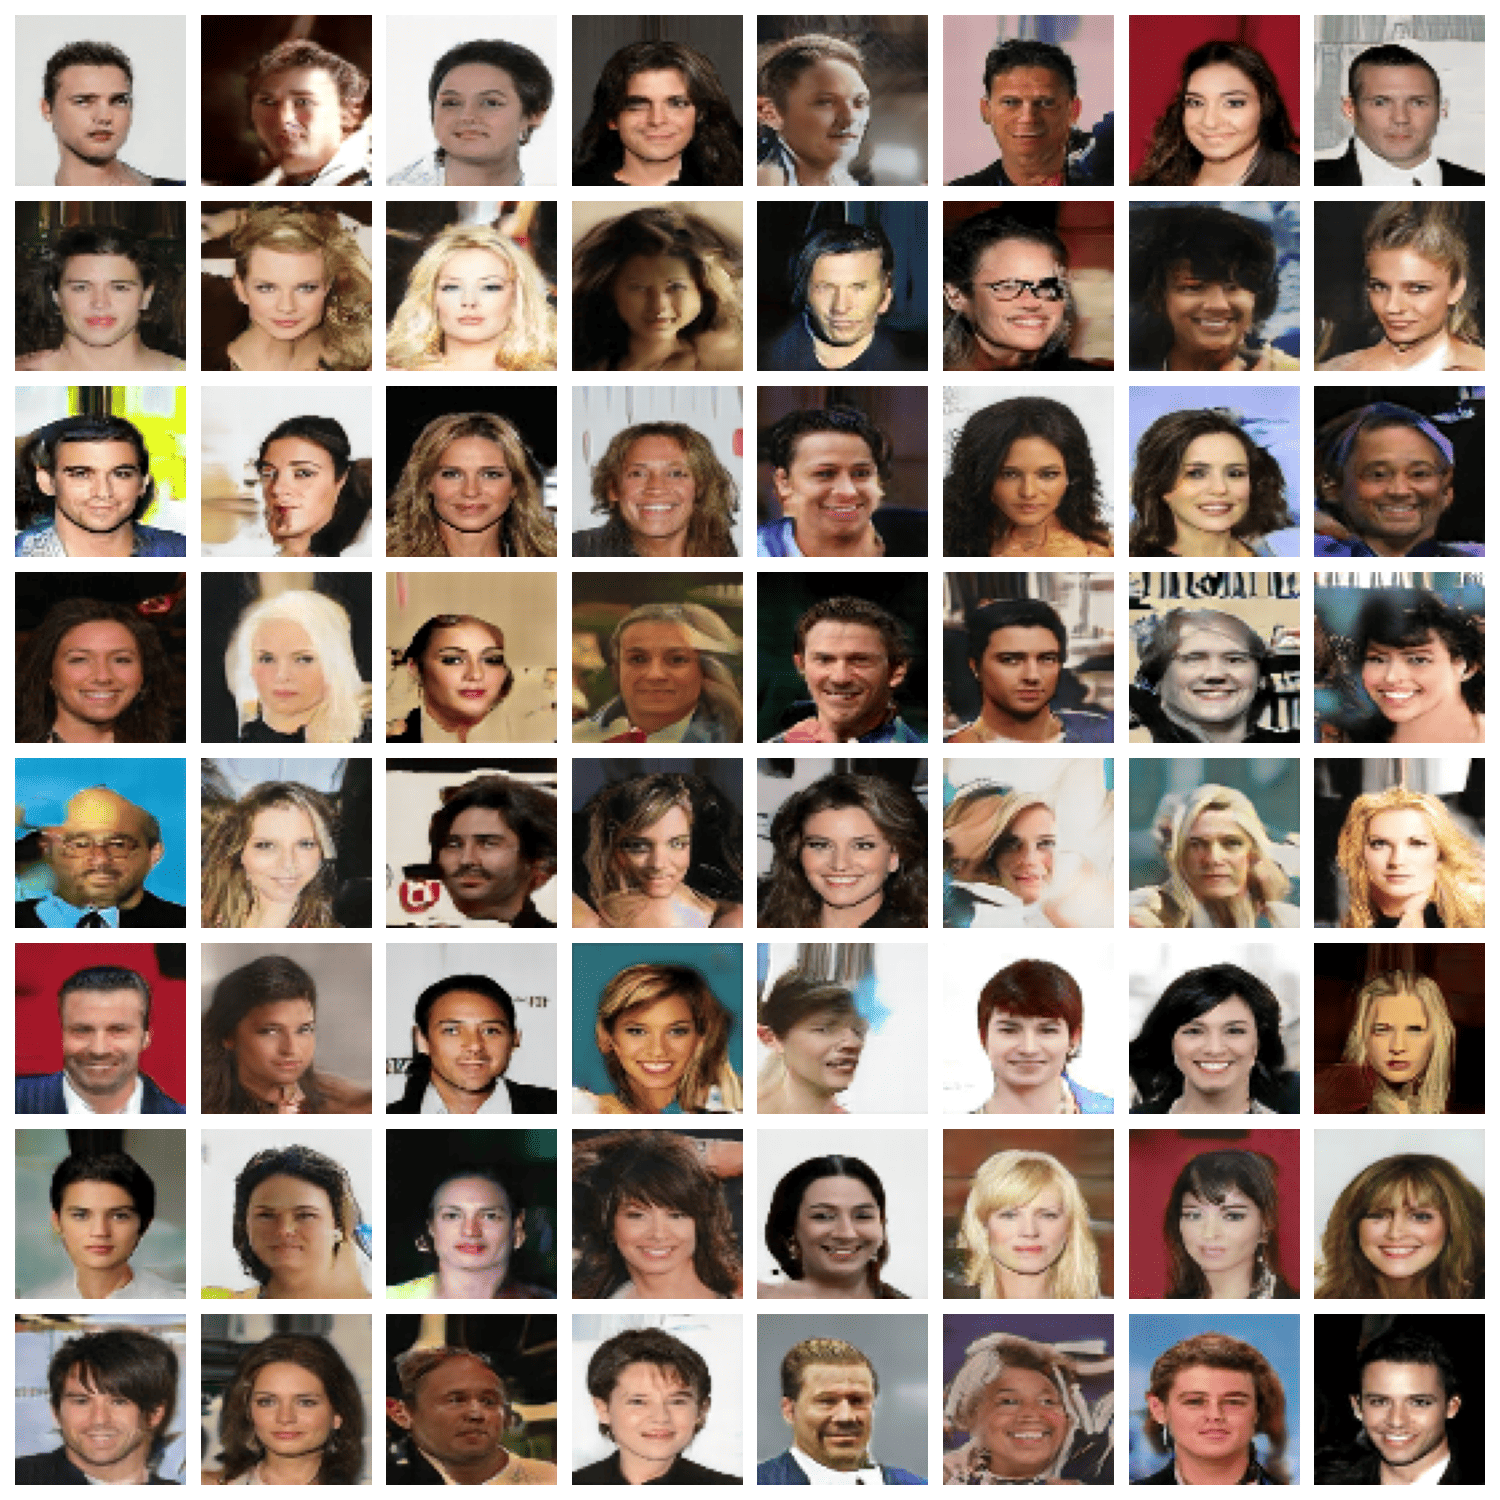
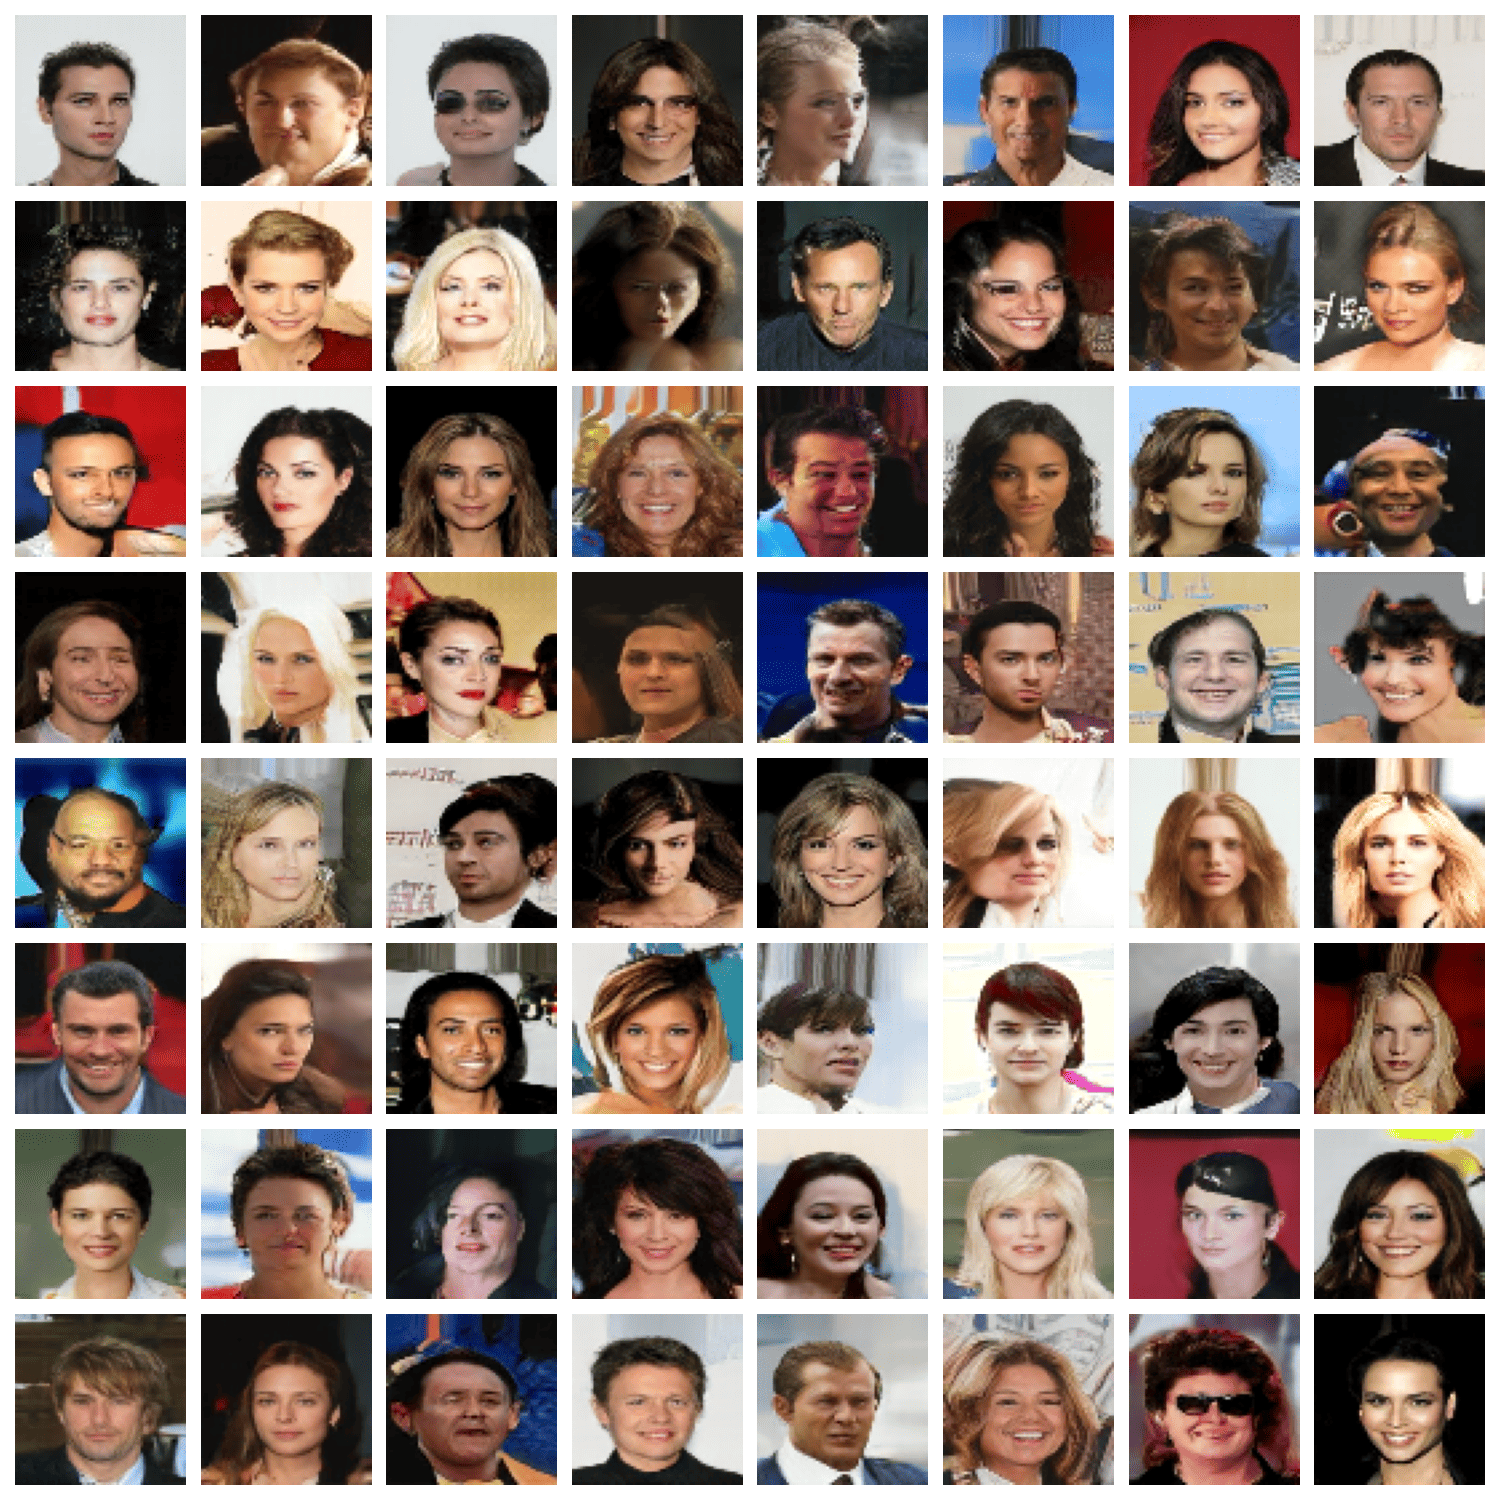
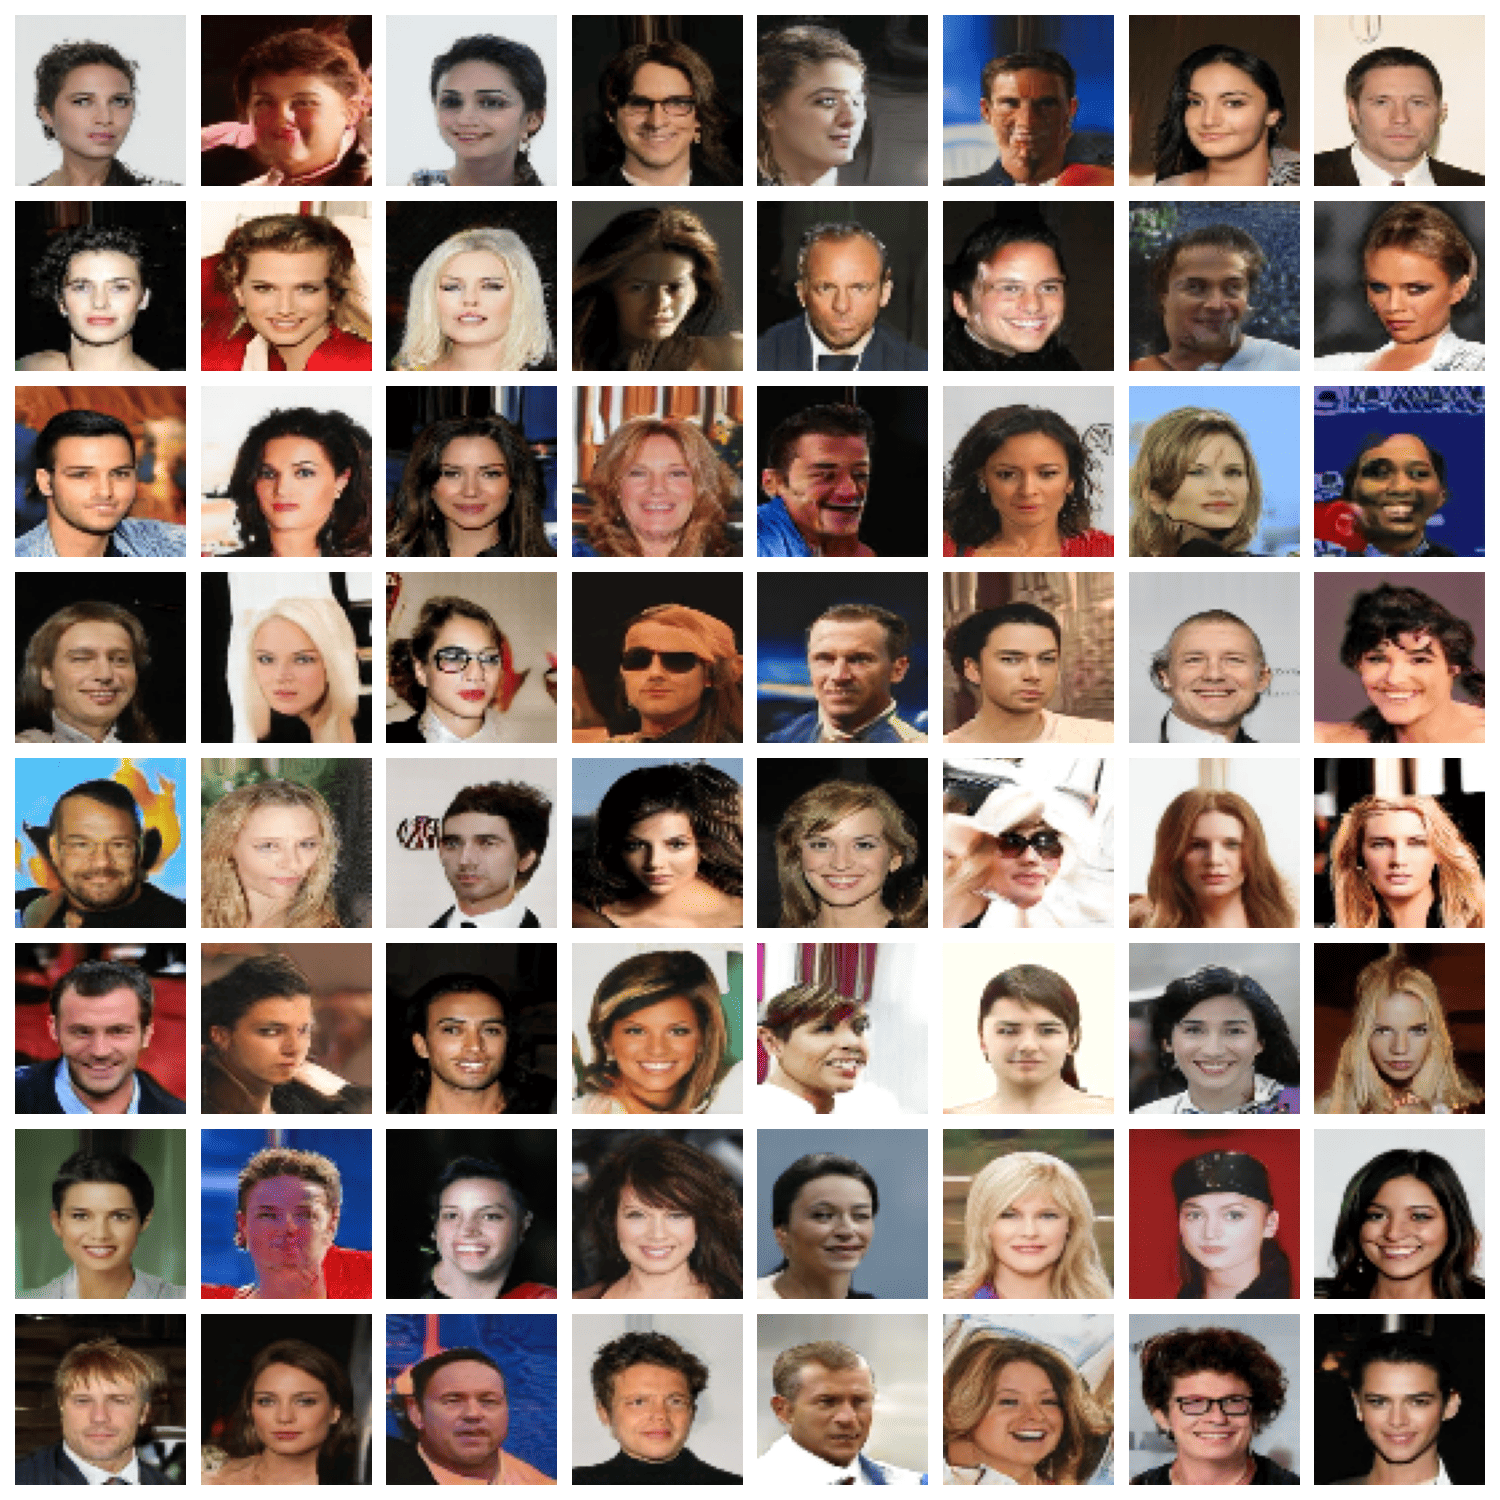
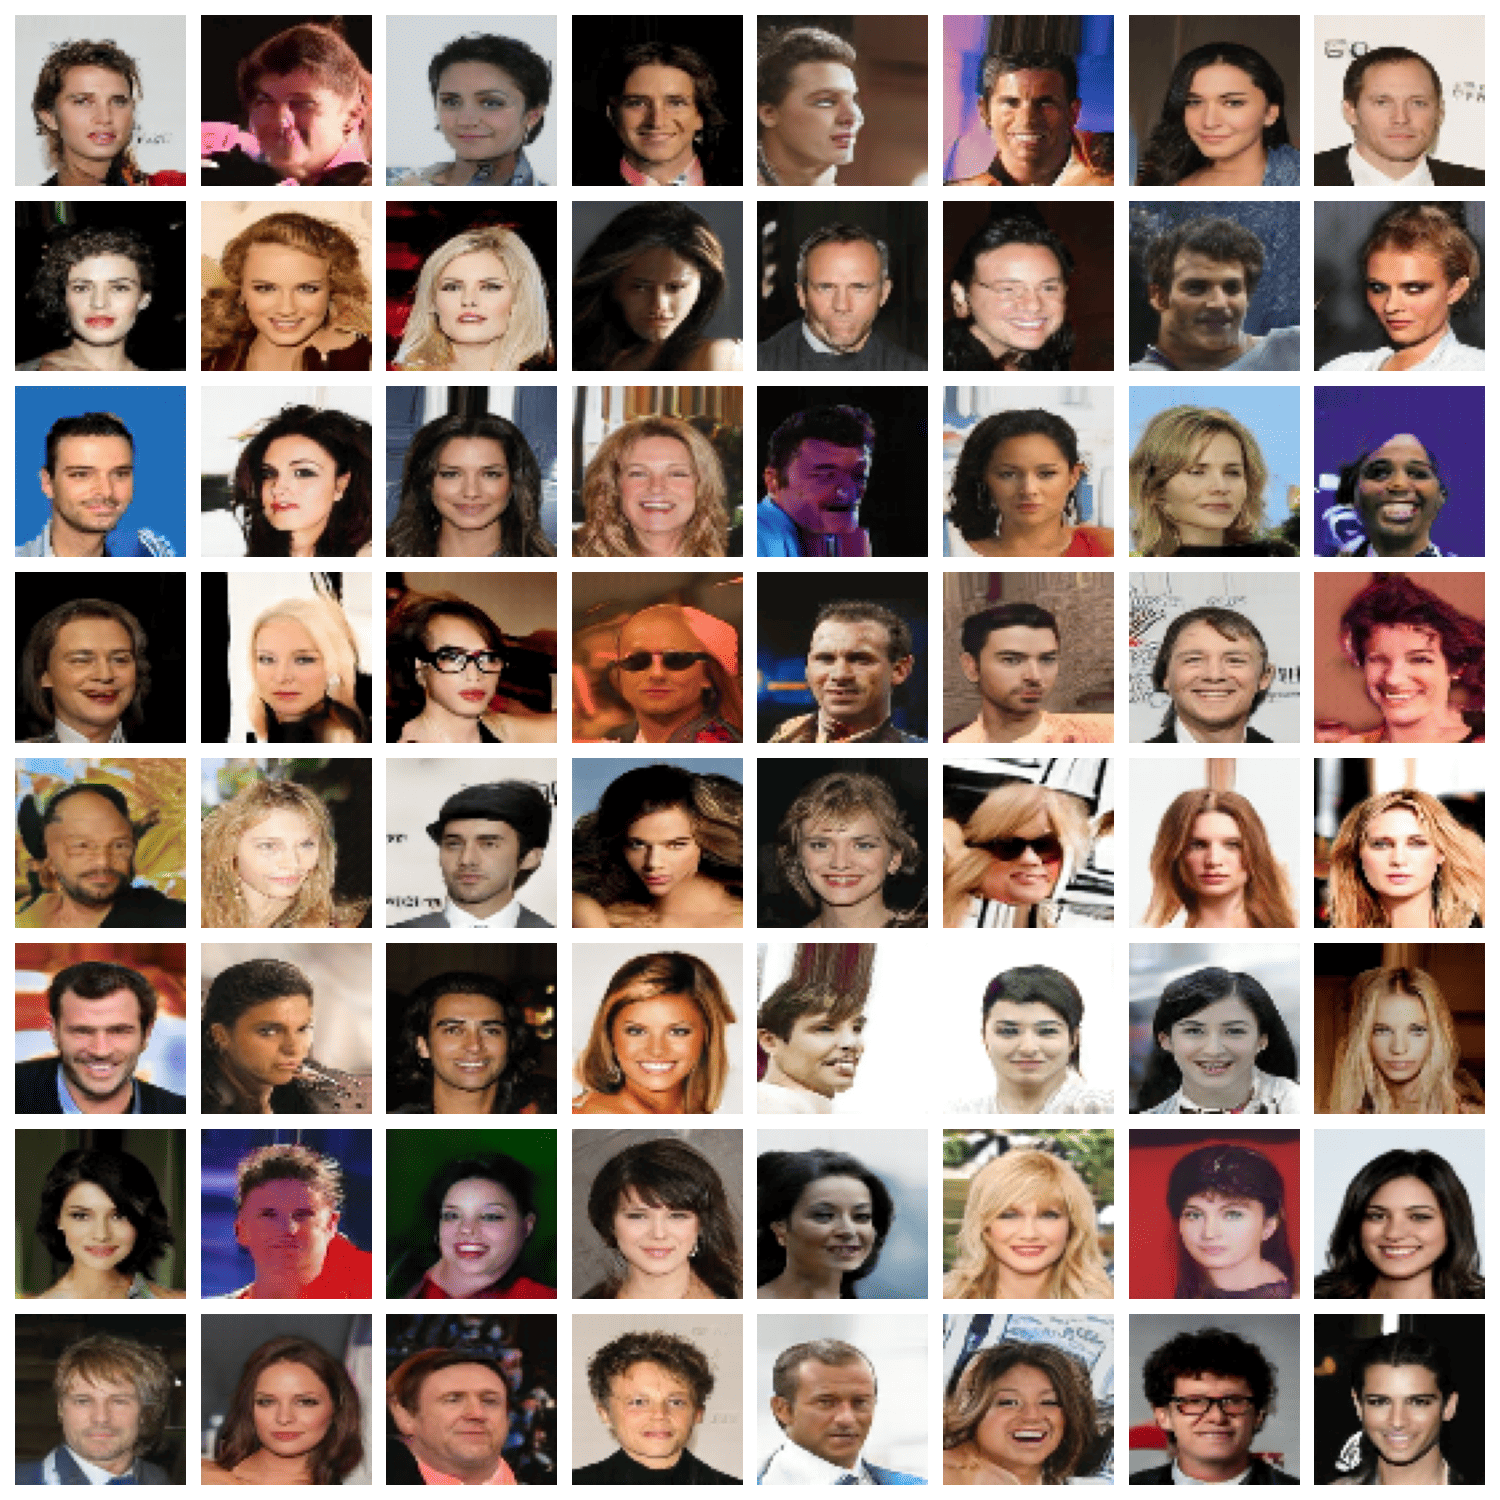
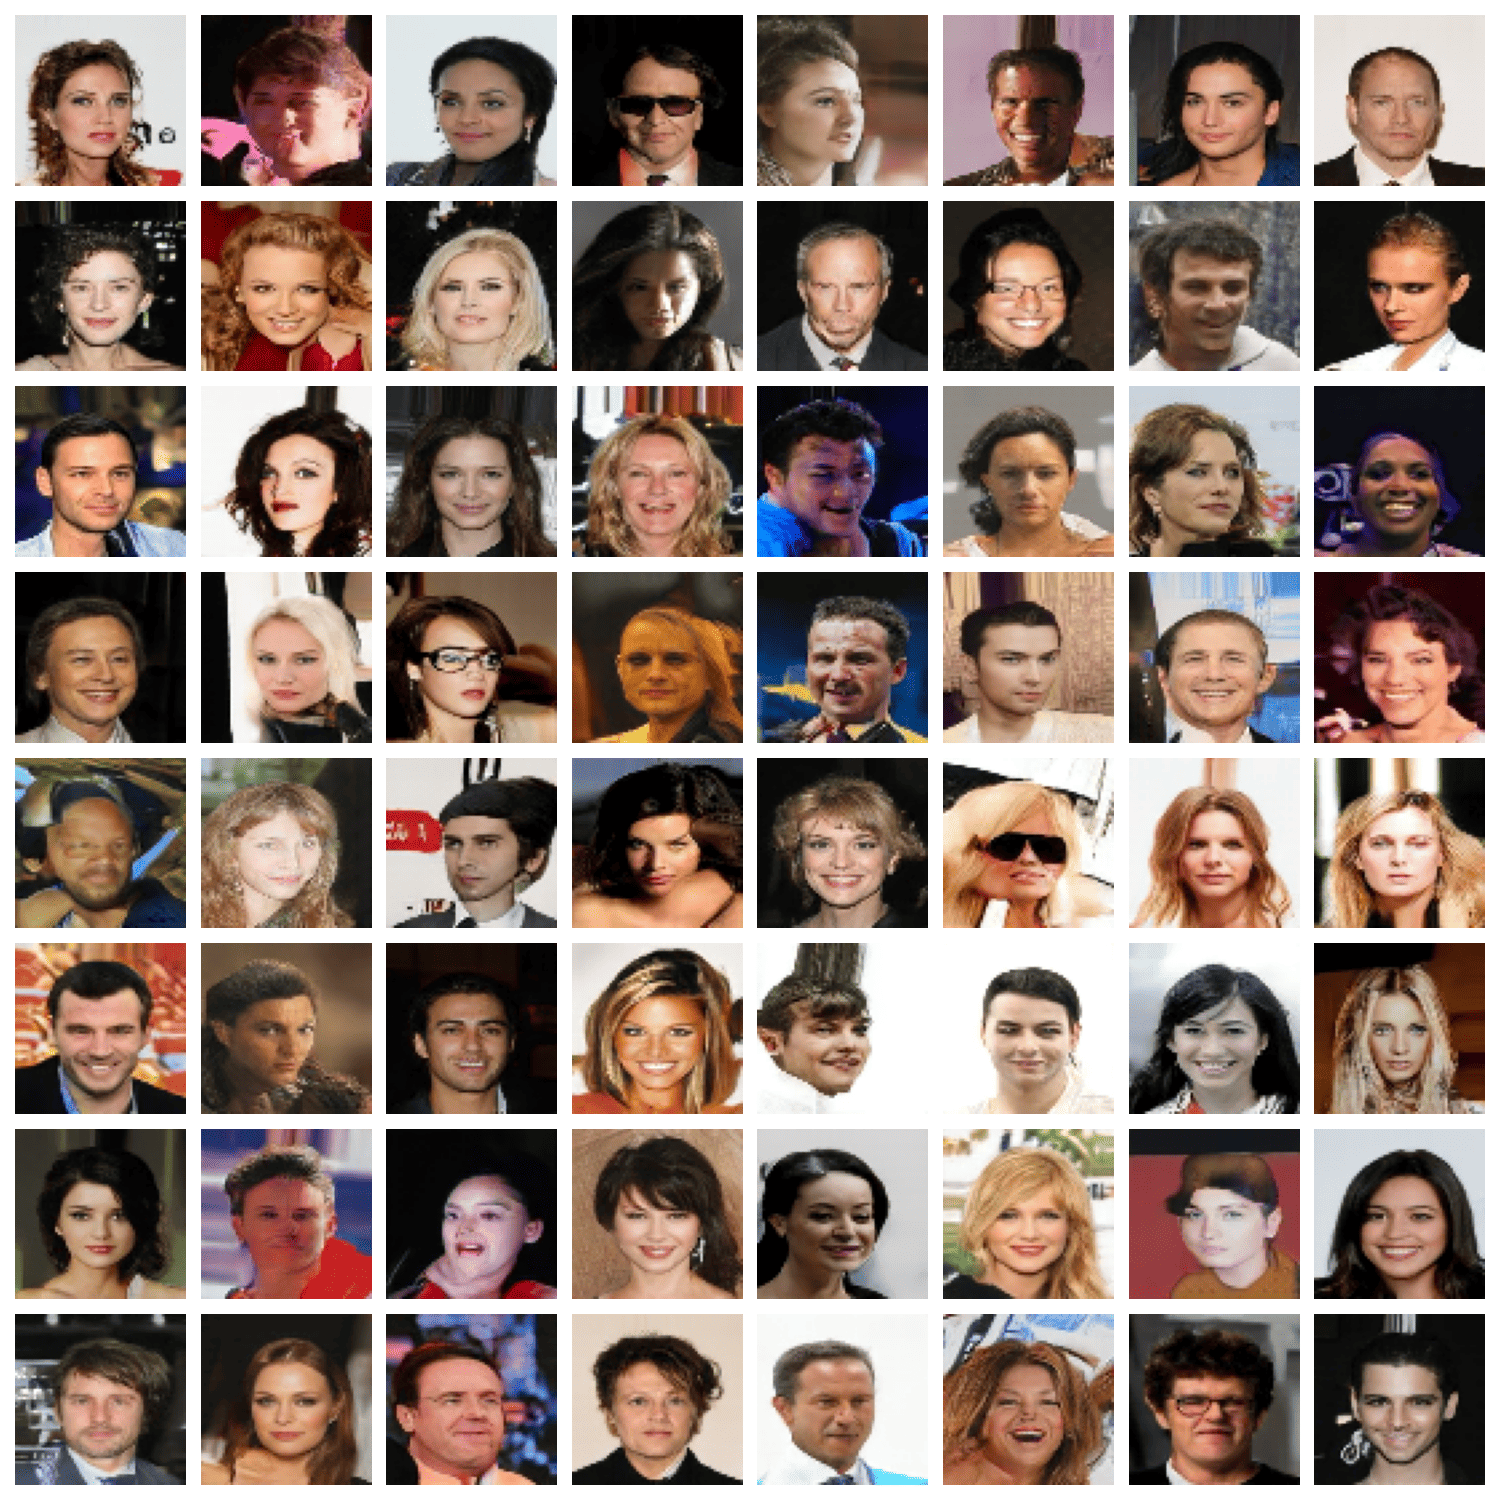
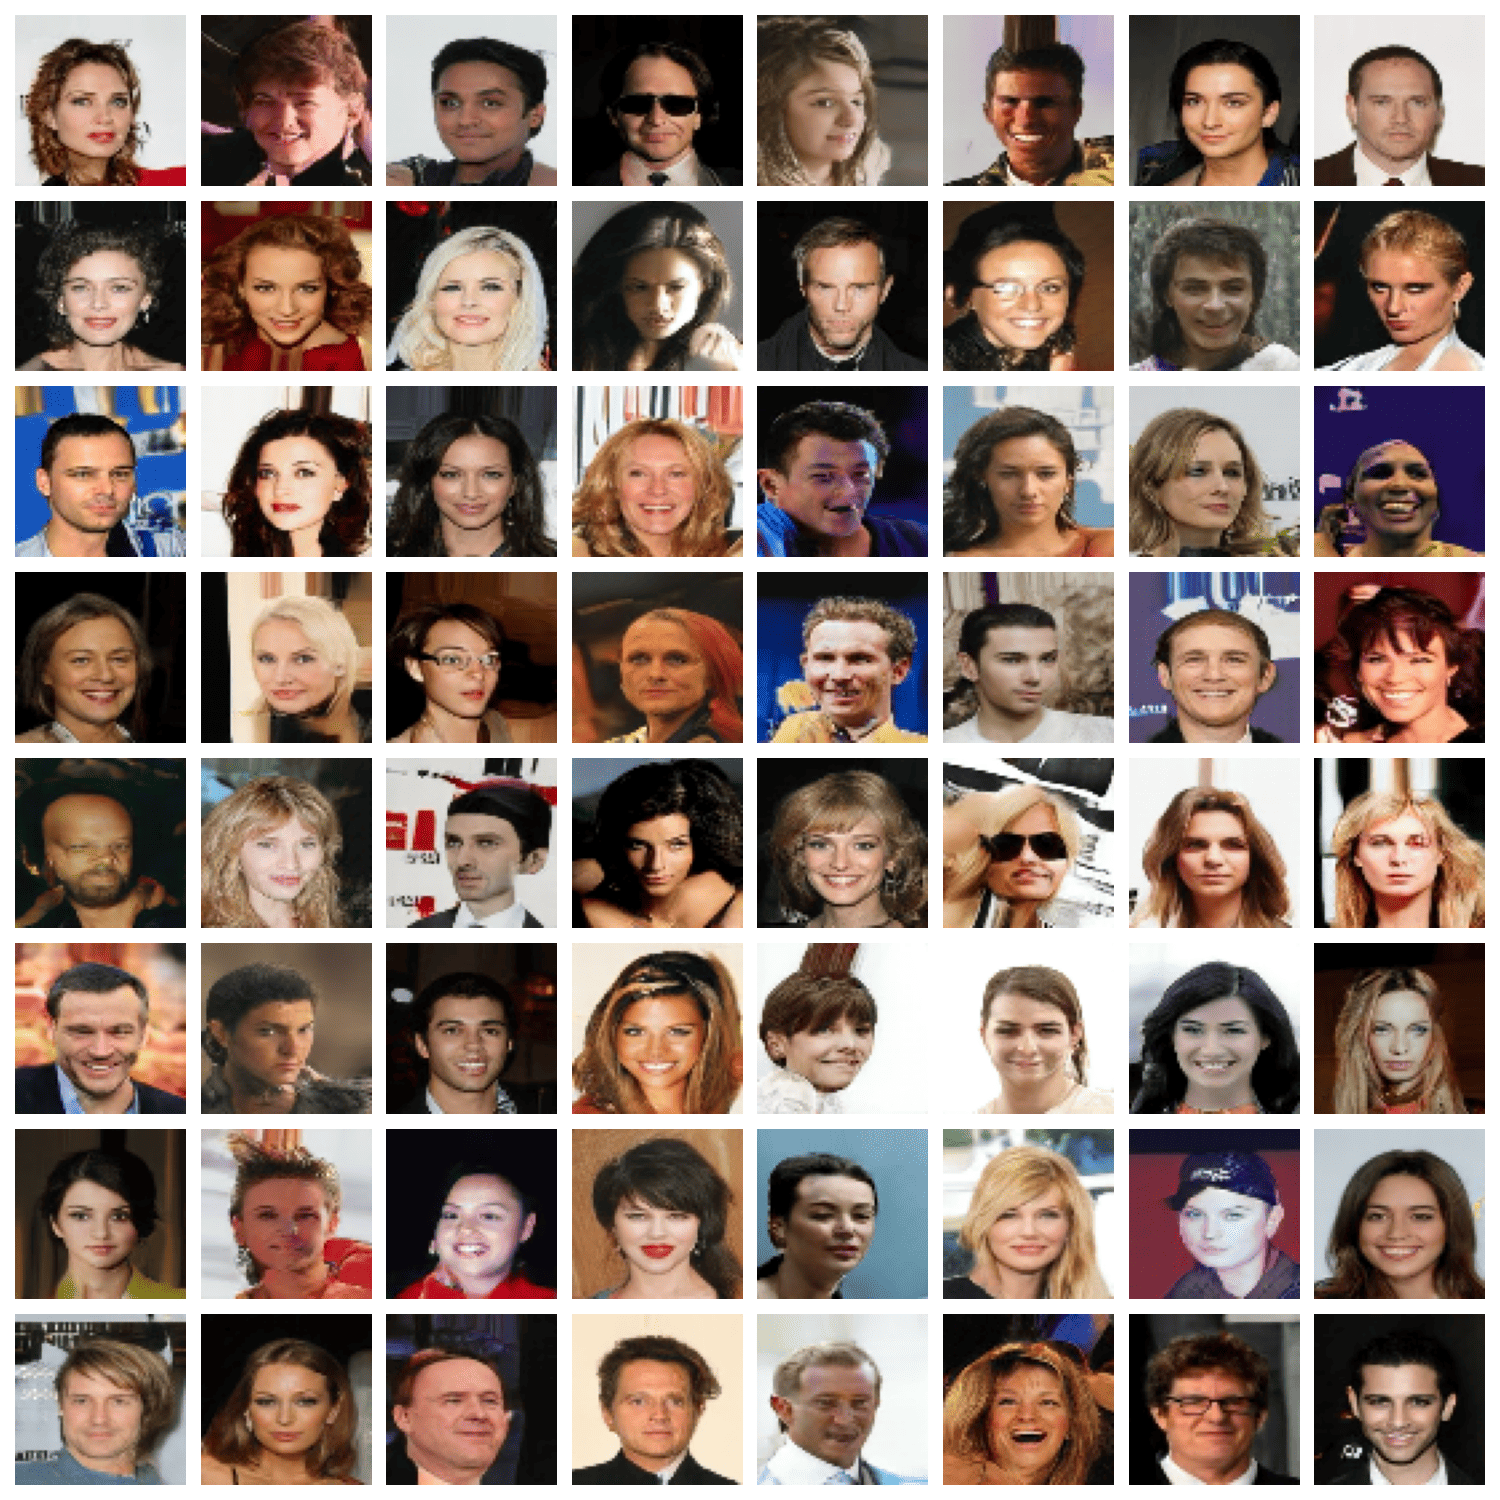
這組圖片展示同一個模型在不同訓練階段產生的人臉,可以觀察臉型、背景與細節如何變化。
判別器:從接近隨機猜測到 EfficientNetV2-B1
生成器完成之後,真正的第二個實驗才開始。判別器資料不是只拿一張 real 和一張 fake,而是把不同 checkpoint 的生成結果集中起來,再和真實資料混合。這個設計讓判別器面對的是一個比較寬的 fake distribution,而不是某一個 epoch 的單一風格。
Backbone 比較
初期比較 EfficientNet B0–B5 和 MobileNetV3-Large 時,結果一度接近隨機猜測(約 50%,常被形容為 coin flip)。後續改用 EfficientNetV2-B1,調整輸入尺寸與微調設定,再進行真假分類。
| Backbone | 報告中的觀察 | 我怎麼使用這個結果 |
|---|---|---|
| EfficientNet B0–B5 | validation 約 0.48–0.53 | 視為初期 baseline,沒有直接沿用 |
| MobileNetV3-Large | 從頭訓練約 0.76 | 作為分類模型的比較對照 |
| EfficientNetV2-B1 | repository README 摘要約 90% validation;原始報告另記錄 30,000 張評估接近 99.907% | 作為最後的判別器,但兩個數字不合併成單一準確率 |
EfficientNetV2-B1 的設定
最後使用 ImageNet 預訓練的 EfficientNetV2-B1,輸入尺寸調整為 240×240×3。backbone(負責抽取影像特徵的主幹網路)大部分先 freeze,只解凍最後 20 層做微調;分類 head 則是:
GlobalAveragePooling2D → Dropout(0.3) → Dense(256, relu) → BatchNorm → Dropout(0.5) → Dense(1, sigmoid)
訓練時使用 mixed precision、AdamW(learning rate 1e-4、weight decay 1e-5),並搭配 EarlyStopping、ReduceLROnPlateau 和 ModelCheckpoint。這裡的重點不是把網路堆到最大,而是讓輸入尺度、資料數量和微調範圍一起對齊。
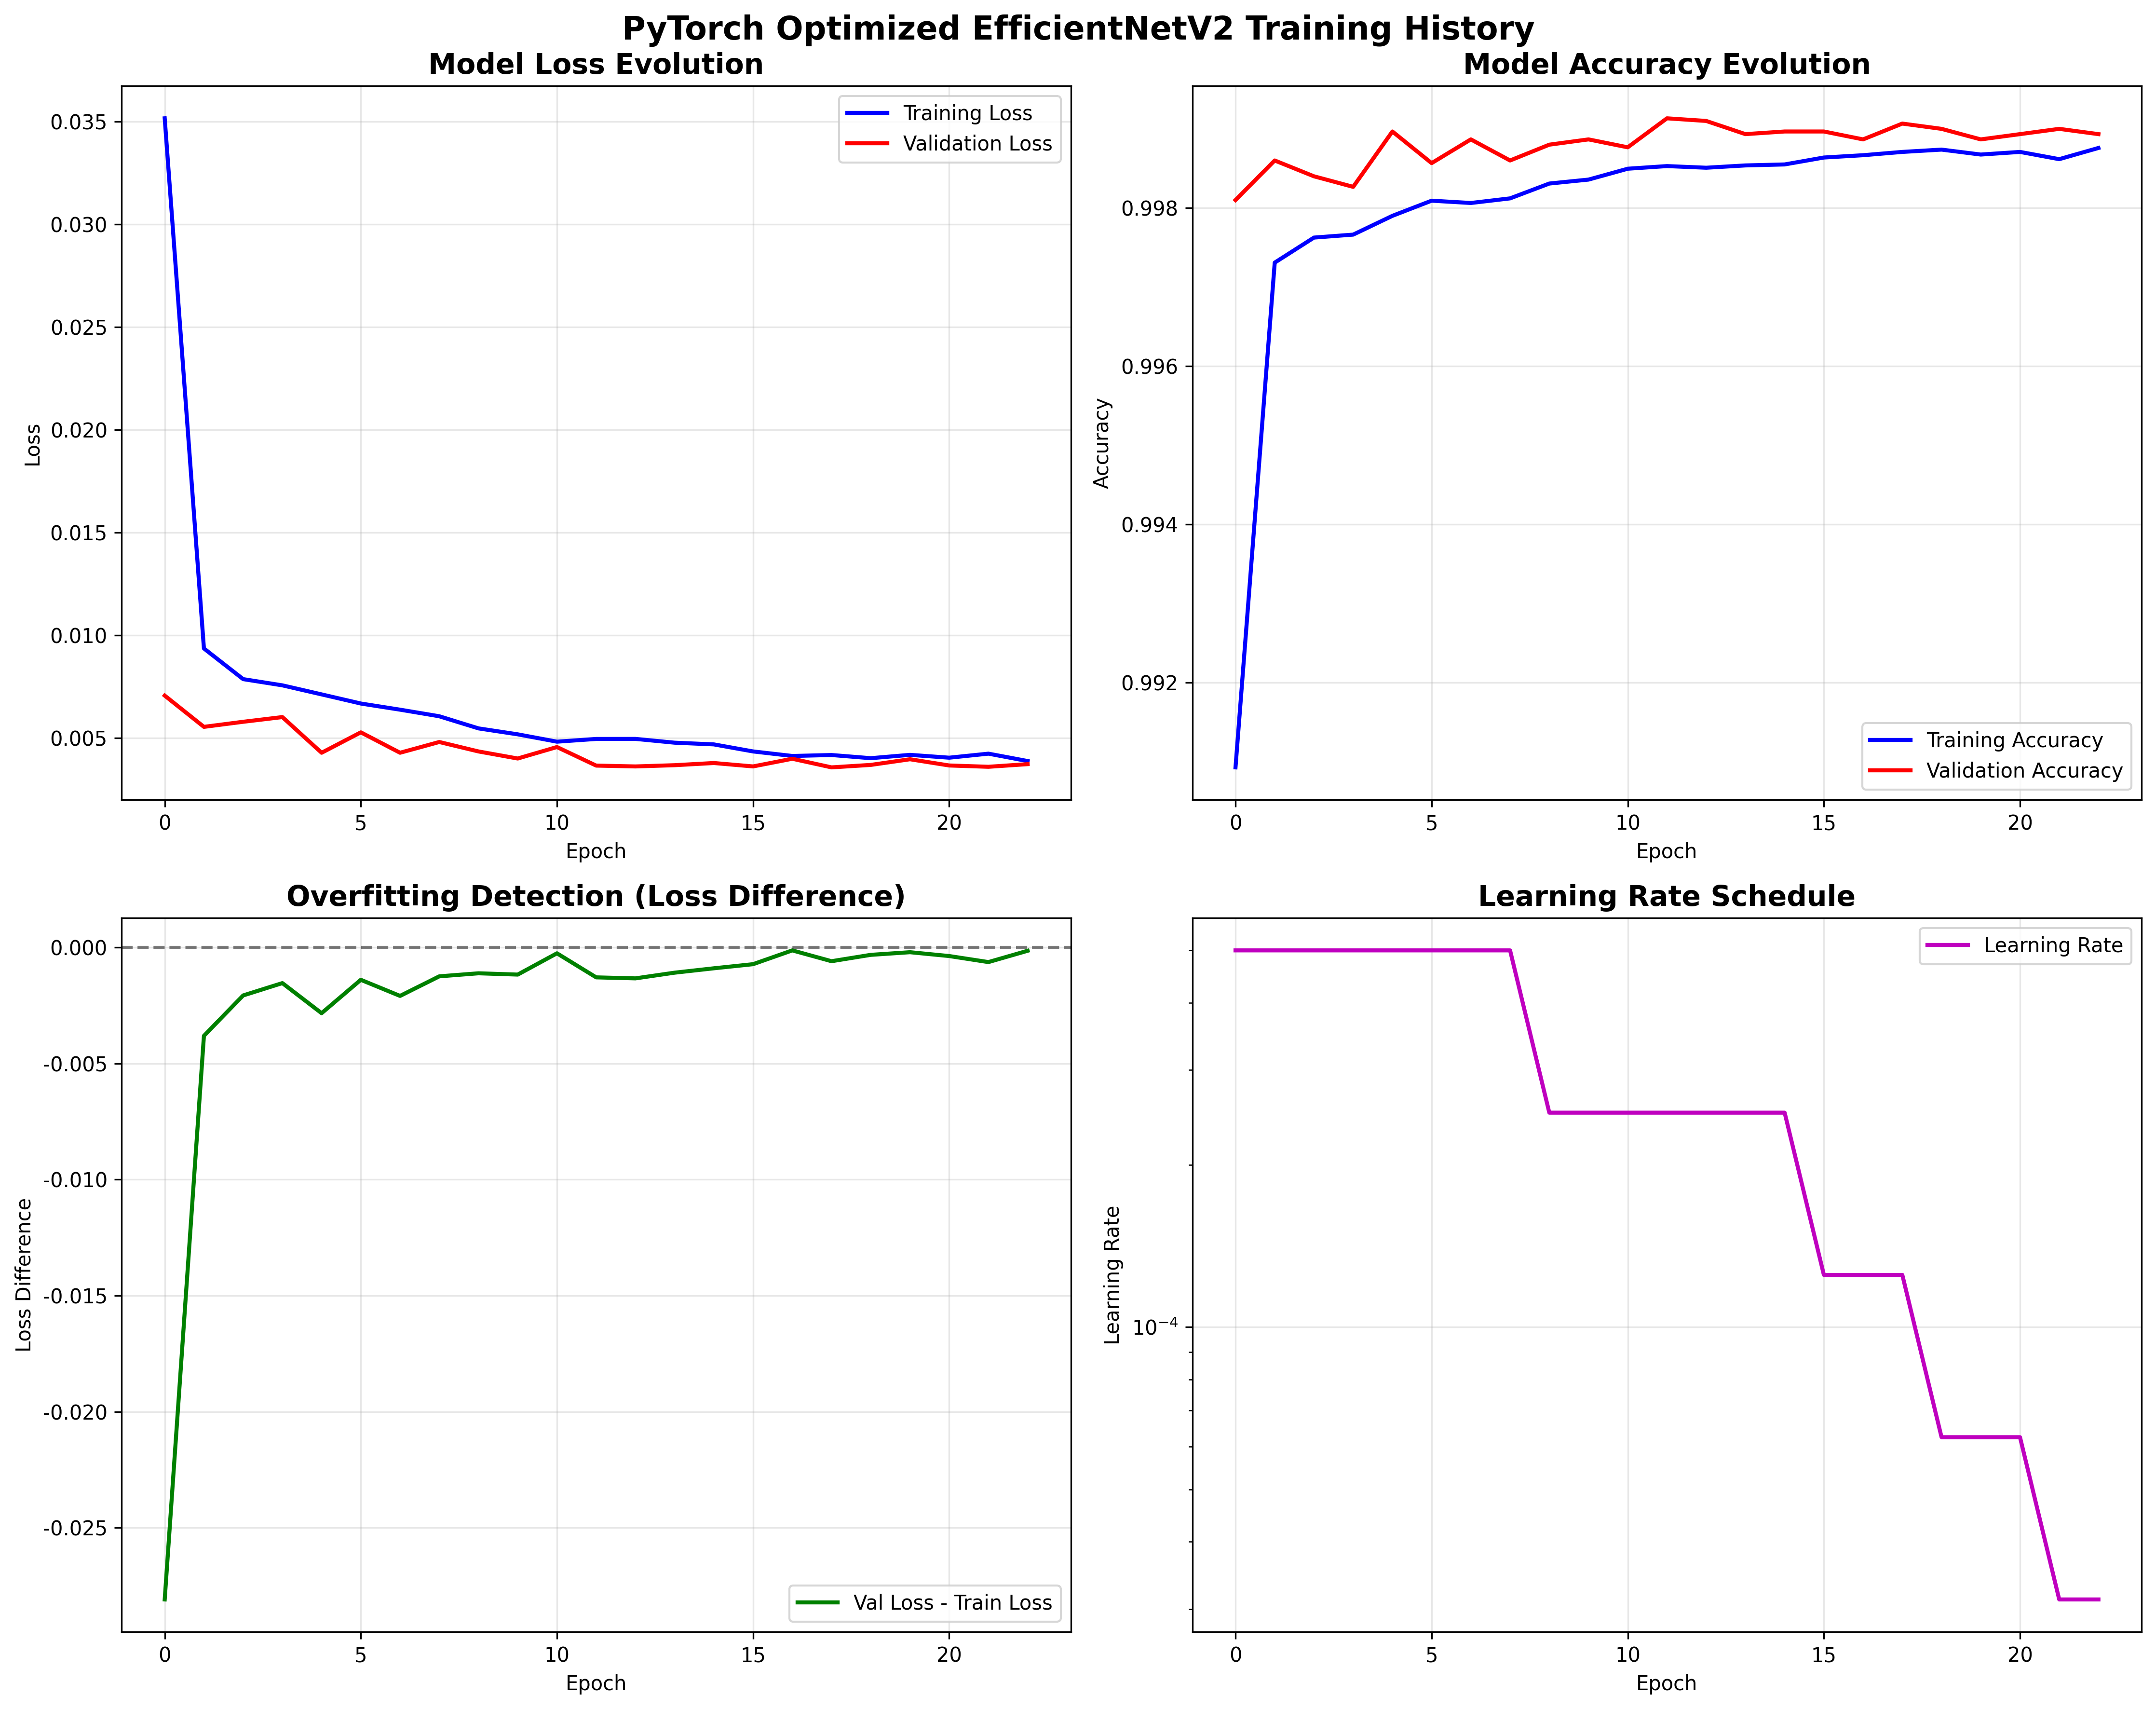
這張圖比單一 validation accuracy 多提供了三種線索:
- loss 是否一起下降,還是只有 accuracy 看起來變好。
- train/validation 的差距是否逐步放大,作為 overfit 警訊。
- learning rate 調整後,模型是否還能繼續改善。
30,000 張評估資料的結果
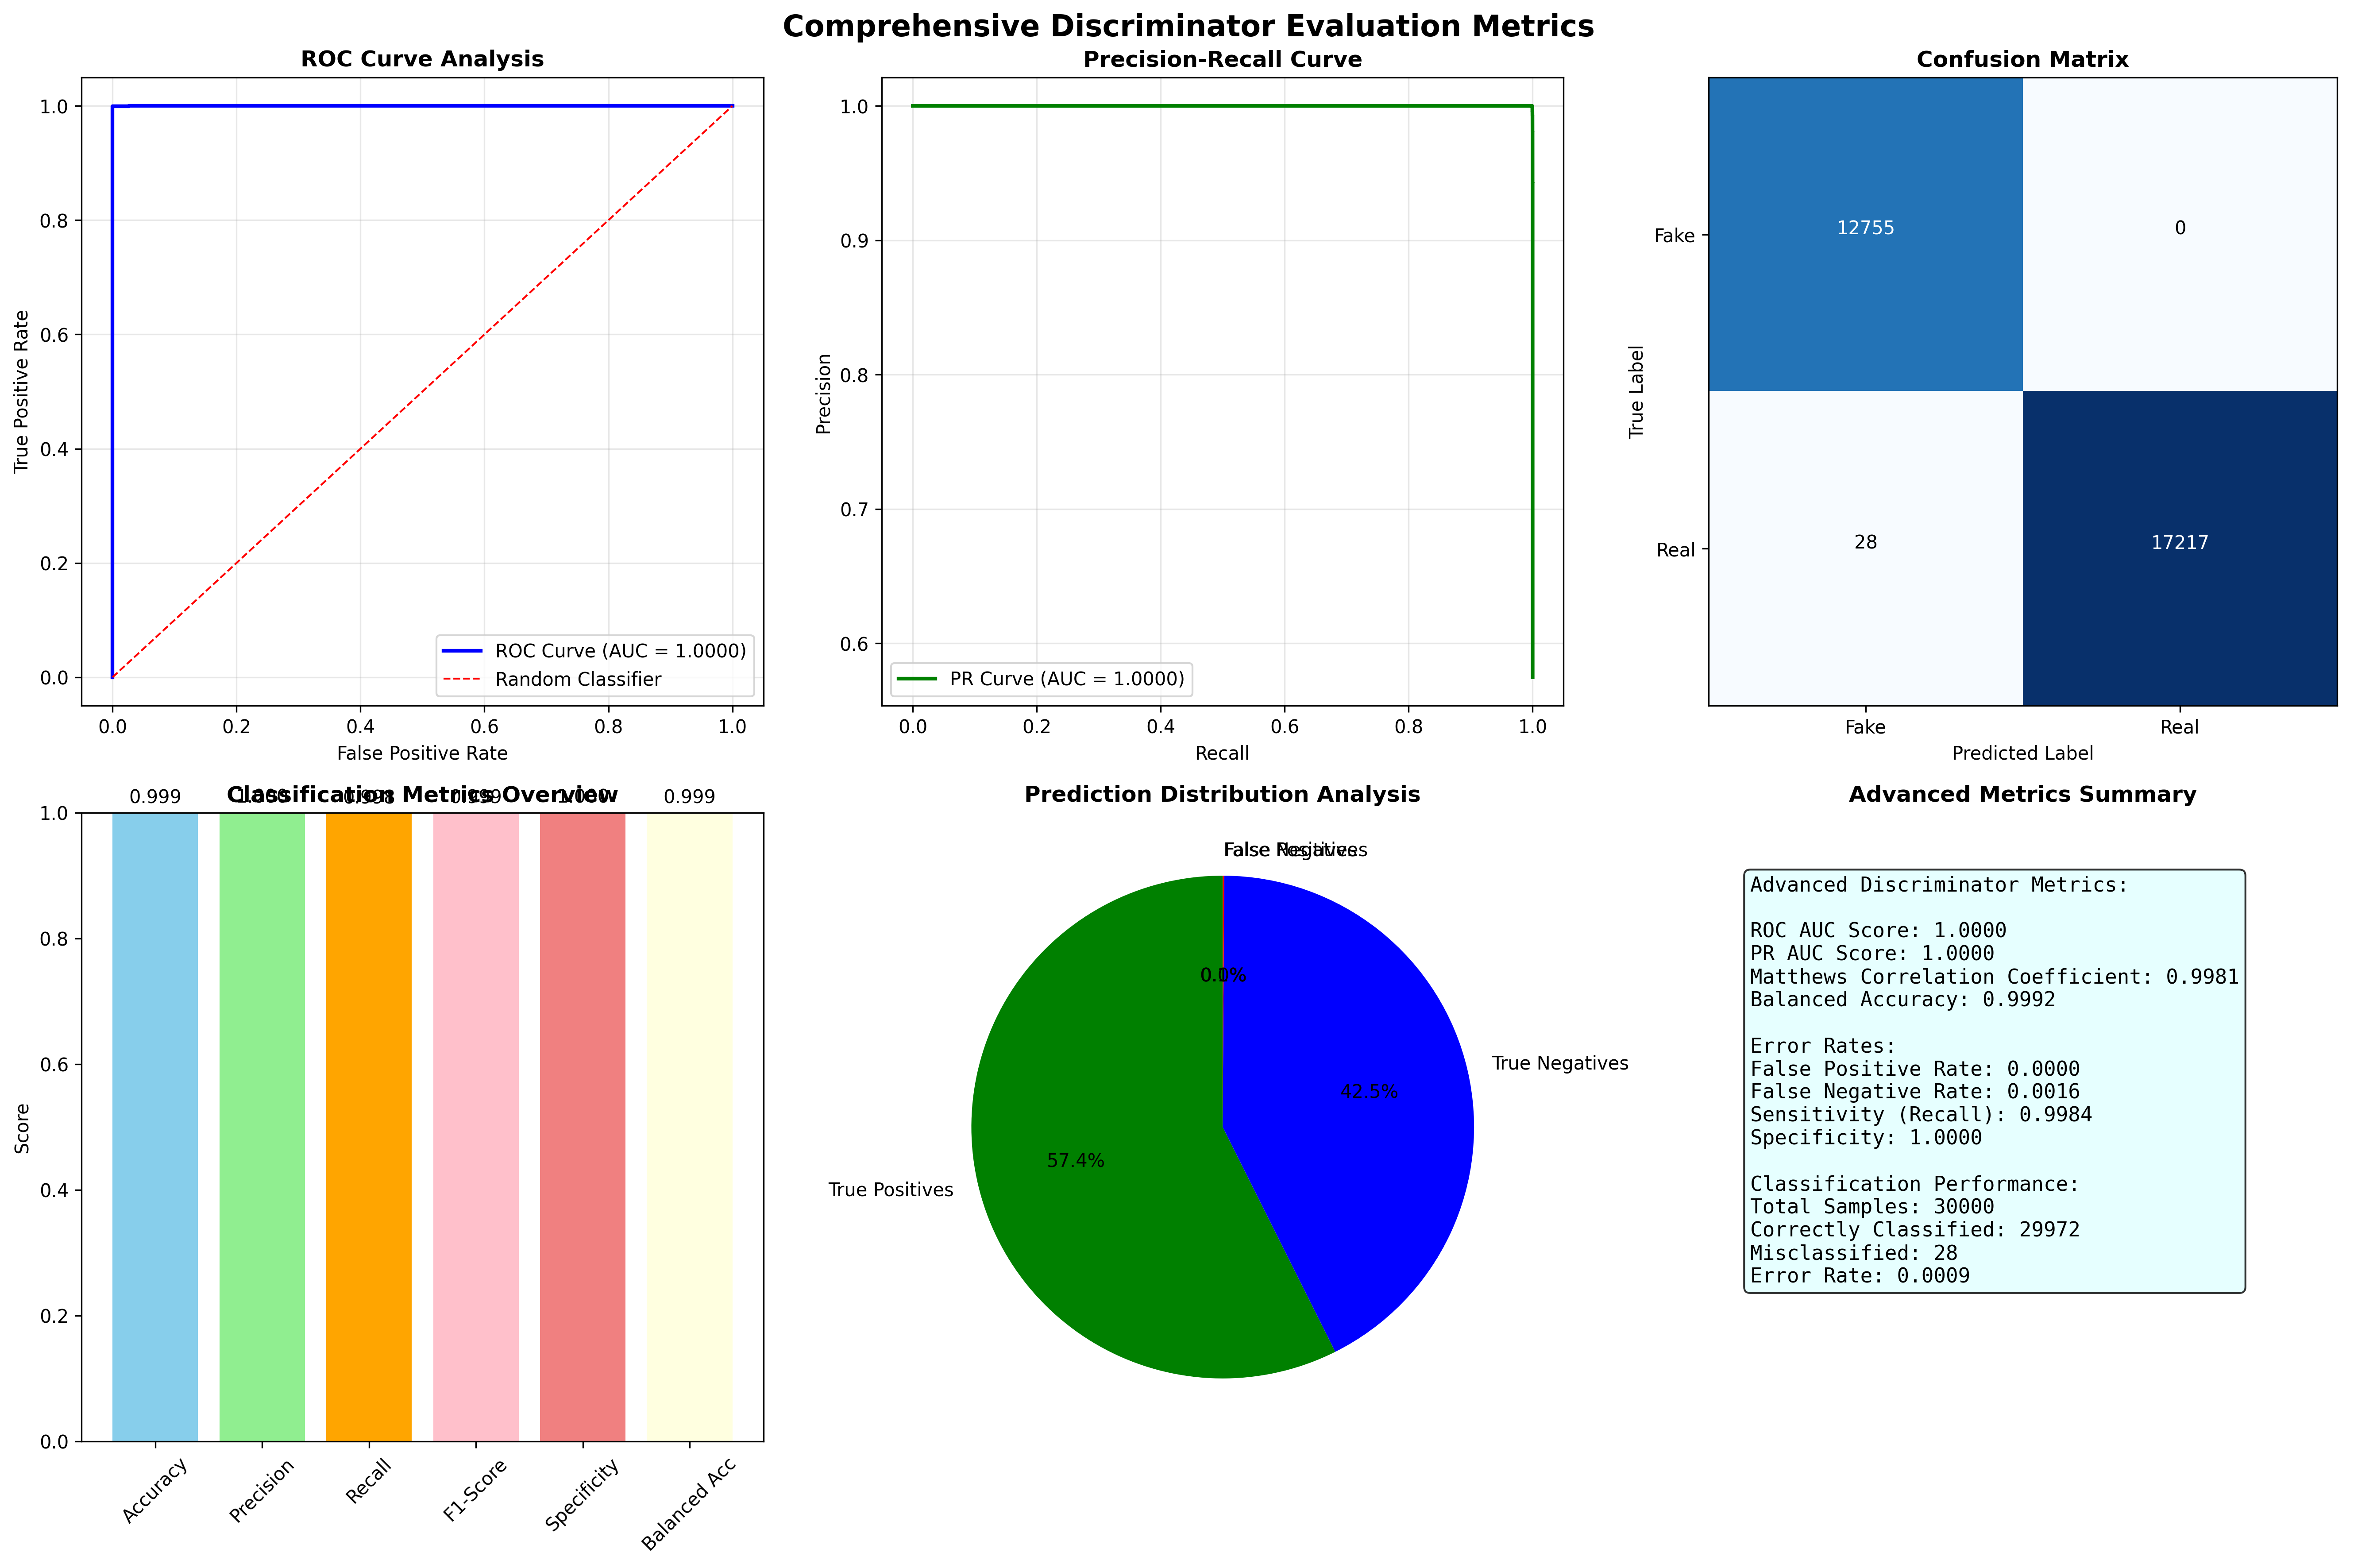
依照 HackMD 評估圖中的 confusion matrix:
- 12,755 張 fake 被正確判為 fake。
- 0 張 fake 被誤判為 real。
- 28 張 real 被誤判為 fake。
- 17,217 張 real 被正確判為 real。
- 總數 30,000 張,正確 29,972 張,計算為約 99.907%。
評估圖另外列出 balanced accuracy 0.9992、sensitivity 0.9984、specificity 1.0000,ROC AUC 和 PR AUC 都是 1.0。
各階段的結果記錄
這份專案的 README 和 HackMD 報告有不同層次的結果摘要:
- README 寫的是約 90% validation accuracy。
- HackMD 另外記錄 30,000 張評估資料中 28 張誤判,也就是約 99.907%。
- 教師提供的 1,000 張測試圖片,分類結果輸出為
test.csv。
工程問題:150K 張圖不是按一下就完成
GPU 記憶體
一次把 150,000 張圖片全部放進記憶體,生成階段很容易遇到 GPU memory overflow。我最後採用 batch generation,定期清理 TensorFlow session,並在適合的地方使用 mixed precision。這些做法不改變模型概念,但決定了實驗能不能跑完。
訓練環境
主要環境是 autoDL 上的 RTX 4090 24GB、Ubuntu 20.04、Python 3.9.16、TensorFlow 2.13.1、PyTorch 2.0.1、CUDA 11.8、cuDNN 8.6;另外在 Ubuntu 22.04、Python 3.10.12 的本地環境做驗證。
HackMD 附錄另記錄了 PyTorch 2.7.1 和 120GB RAM 的環境。
公開原始碼包含模型訓練、圖片生成與資料建立腳本。
分類不應只看模型大小
初期模型接近 coin flip 時,我沒有直接換成更大的 backbone,而是一起檢查:
- fake/real 的數量比例與 label 產生腳本。
- 生成圖片與真實圖片的 resize、normalize 和色彩格式。
- EfficientNet 的輸入尺寸是否適合目前的資訊量。
- validation split 是否把同一個 checkpoint 的風格洩漏到 train 和 validation。
- classification head 是否太容易記住背景、壓縮痕跡或前處理差異。
這些檢查比單純把 B0 換成 B5 更接近問題本身。
報告中的主要取捨
LadaGAN 作者的 benchmark 記錄 FID 1.81;FID 用來衡量生成影像與真實影像的分布差異。我的作業報告另外記錄約 19M 參數,以及單張 RTX 4090/3080Ti 上 30 epochs 小於 5 小時的訓練時間。
這次最重要的取捨可以濃縮成下面這張表:
| 方案 | 清晰度 | 多樣性 | collapse | 成本 | 整體判斷 |
|---|---|---|---|---|---|
| DCGAN + Attention | 高 | 低 | 嚴重 | 1× | 細節好看,但不夠可靠 |
| WGAN-GP | 中 | 高 | 明顯改善 | 約 3–4× | 穩定,但速度與細節成本高 |
| LadaGAN | 高 | 高 | 輕微 | 中等、報告記錄小於 2× | 最符合這次作業的交付條件 |
我從這份作業真正學到的事
生成模型的比較同時觀察清晰度、多樣性、訓練穩定性與生成成本。Attention-DCGAN 的細節較清楚,但臉型逐漸集中;WGAN-GP 改善了多樣性,也增加了訓練時間。
分類實驗的記錄包括 README 中約 90% 的驗證準確率、報告中的 30,000 張評估結果,以及教師提供的 1,000 張測試圖片。每一項結果都列在對應的資料與評估階段旁。
最後採用 LadaGAN,是因為它在這份作業中取得了較合適的影像清晰度、多樣性與運算成本。前面各模型的生成樣本與訓練曲線,呈現了這個選擇的比較過程。
如果再做一次
下一輪我會先補上資料治理,再追求更高的指標:
- 為每張圖片保存 source_type、source_epoch、checkpoint、seed 和 preprocessing 版本。
- 明確分開 train、validation、hold-out test,避免同一個 checkpoint 的風格同時出現在不同 split。
- 對每個 epoch 做固定 seed 的 sample grid,並加上 FID、KID、precision/recall for generative models。
- 讓判別器在跨 checkpoint、跨來源與不同壓縮設定的資料上測試,確認它學到的是生成分布,而不是資料管線的指紋。
- 用同一份 environment lock 和命名規則重跑全部 pipeline,讓別人可以從 train_celeba.py、generate_image.py、LabelData.py、efficientnetv2.py 到 test_face.py 逐段核對。